Serviços de IA (locais)
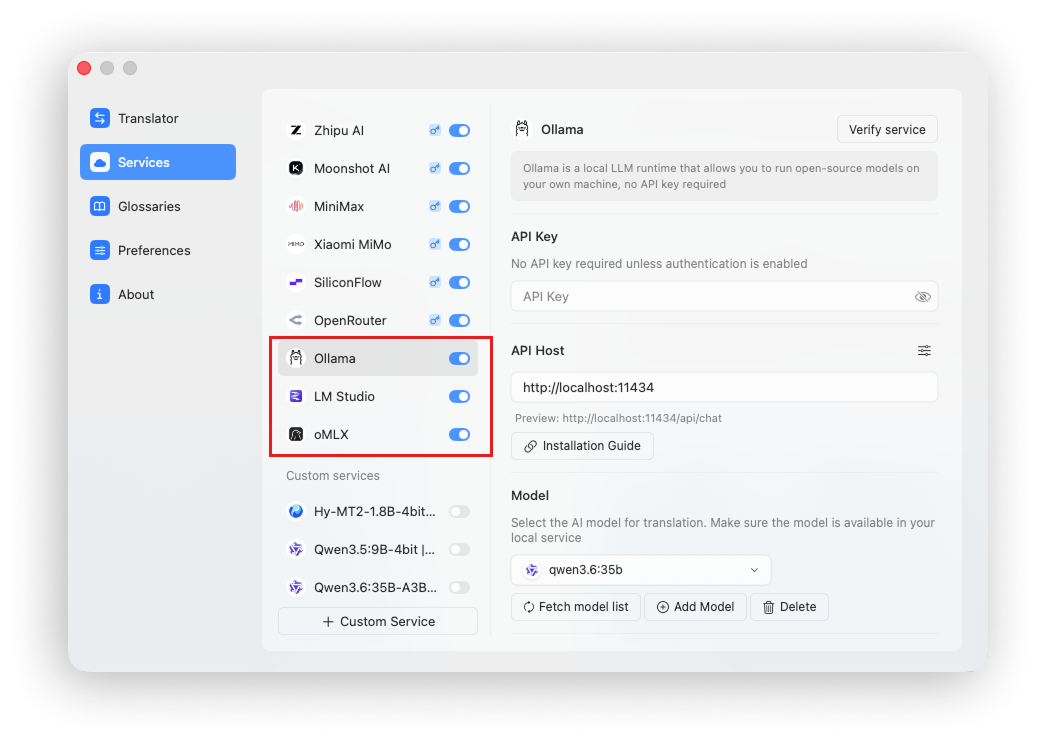
Doco Translate pode se conectar a tempos de execução de modelo de IA locais, como Ollama, LM Studio e oMLX para tradução.
Avantagens dos modelos locais
Usar modelos locais é a abordagem que Doco Translate recomenda mais fortemente porque oferece várias vantagens importantes.
Qualidade da tradução
Modelos de linguagem grandes se destacam em tarefas de linguagem natural, especialmente tradução. Eles geralmente oferecem melhor qualidade de tradução do que os mecanismos de tradução automática convencionais.
Privacidade
Modelos carregados por meio de um tempo de execução local mantêm seus dados em seu dispositivo. Nada é enviado a um fornecedor terceirizado, garantindo que o processamento de documentos permaneça privado.
Custo
Ao contrário das APIs de IA em nuvem, os modelos locais não cobram por tokens e não têm taxas de uso adicionais.
Limitações de modelos locais
Tamanho do modelo
Os modelos locais geralmente são de código aberto e os modelos que funcionam bem em hardware de consumo geralmente têm contagens de parâmetros relativamente pequenas, como 4B, 9B, 35B-A3B ou 27B. As suas capacidades gerais podem, portanto, ser mais fracas do que os grandes modelos de nuvem.
No entanto, a tradução não requer uma cadeia de raciocínio muito longa ou o modelo de raciocínio mais forte possível. Modelos locais menores são capazes de produzir boas traduções, o que os torna uma escolha altamente econômica.
Velocidade de inferência
A velocidade de inferência local depende do seu hardware e do tamanho do modelo. Hardware melhor e modelos menores são mais rápidos, embora a inferência local geralmente ainda seja mais lenta do que uma API de IA em nuvem.
Tempos de execução do modelo de IA local
| Ferramenta | Características |
|---|---|
| Ollama | Configuração simples pela linha de comando e gerenciamento de modelos |
| LM | Interface gráfica amigável para download e execução de modelos locais |
| oMLX | Inferência LLM local de alta velocidade otimizada para silício Apple |
Ollama
Ollama é uma ferramenta de linha de comando acessível para executar modelos locais.
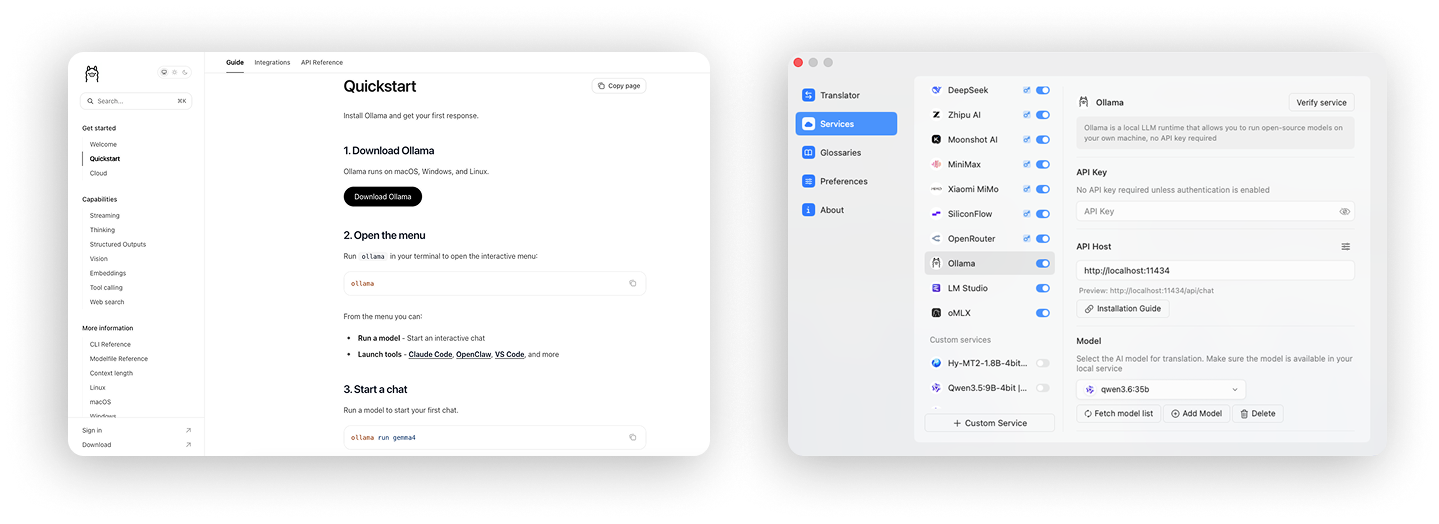
Instale o Ollama seguindo suas instruções oficiais e execute ollama pull MODEL_NAME para baixar um modelo.
Depois que o modelo for baixado e executado com sucesso no Ollama, conecte-o a Doco Translate com um clique.
O endpoint padrão do Ollama é http://localhost:11434.
LM
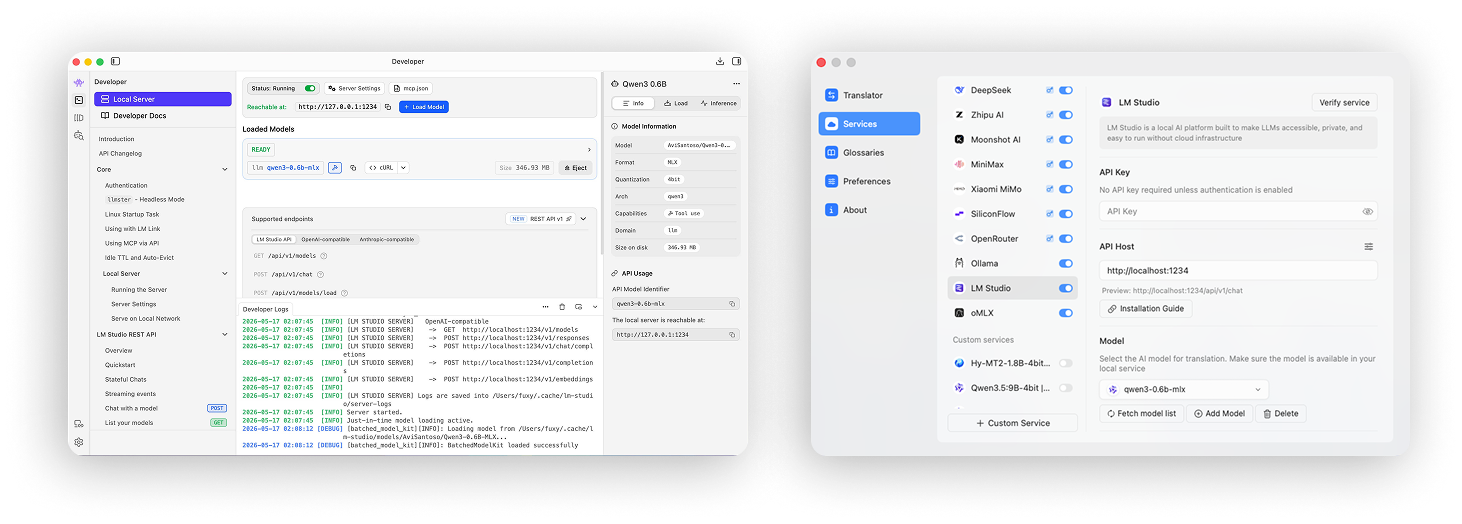
LM Studio fornece uma interface gráfica para executar modelos locais e é fácil de começar.
Instale o LM Studio de seu site oficial e baixe um modelo dentro do aplicativo.
Após o download do modelo, inicie o servidor de modelo local do LM Studio para que ele exponha uma API. Você pode então conectá-lo a Doco Translate com um clique.
O endpoint padrão do LM Studio é http://localhost:1234.
oMLX
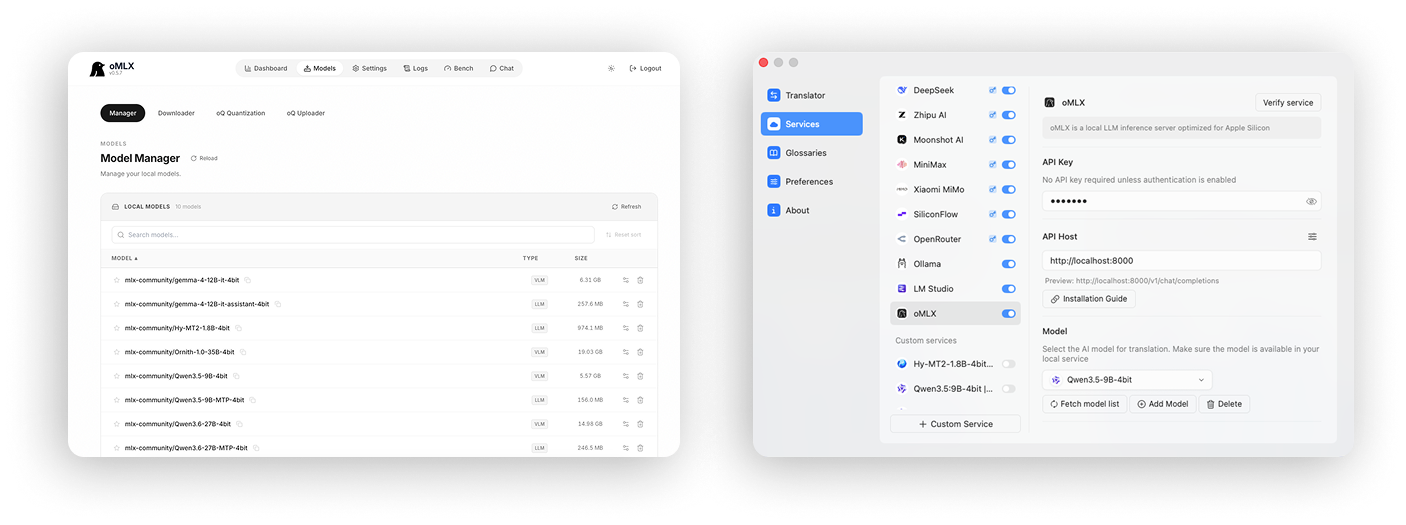
oMLX é um tempo de execução de modelo local otimizado para silício Apple e fornece inferência muito rápida.
Instale o oMLX de seu site oficial, abra o console oMLX e baixe um modelo.
oMLX inicia seu serviço local automaticamente. Depois que o modelo for baixado e aprovado no teste, conecte-o a Doco Translate com um clique.
O endpoint padrão do oMLX é http://localhost:8000.
Modelos recomendados
Doco Translate recomenda os seguintes modelos para tradução:
- Hy-MT2-1.8B: muito rápido, uso mínimo de memória e otimizado especificamente para tradução
- Qwen3.5:9B: rápido com uso de memória relativamente baixo
- Qwen3.6:35B-A3B: fortes recursos e desempenho rápido, com maior uso de memória
- Gemma4:12B: uma escolha equilibrada para qualidade, velocidade e uso de memória
- Qwen3.6:27B: os recursos mais fortes, mas mais lentos e com uso intenso de memória
- Qwen3.5:4B: rápido com pouco uso de memória, mas um pouco menos estável
Para a maioria das cargas de trabalho, use Hy-MT2-1.8B ou Qwen3.5:9B como modelo principal. Ambos são rápidos e eficientes em termos de memória. Para maior qualidade e estabilidade, use Qwen3.6:35B-A3B, que é mais capaz, mas consome mais memória.