AI 翻譯服務(本地)
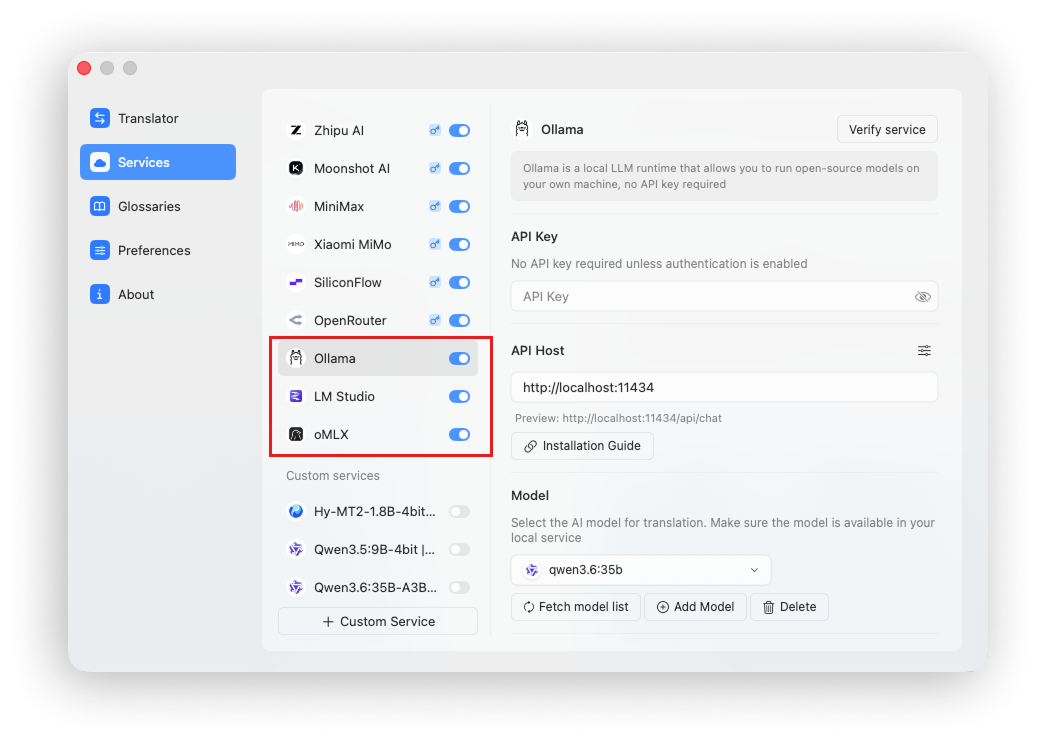
Doco Translate 支援連接本地的AI 大模型運行環境(Ollama、LM Studio、oMLX 等),進行翻譯
本地模型優勢
結合本地模型使用,是Doco Translate 最推薦的使用方式,他有幾個比較顯著的優勢
翻譯質量
AI 大語言模型最擅長解決自然語言的處理,尤其是翻譯場景,效果出色,翻譯品質比機器翻譯引擎更好
隱私安全
透過本地運行環境加載的模型,資料不會傳送到第三方服務商,所有處理都在本機進行,確保資料的絕對安全私密
成本優勢
比起API 方式呼叫AI 大模型服務,不需要花錢購買token 的費用,沒有額外的經濟開銷
本地模型劣勢
模型參數
本地模型通常是開源模型,可用於消費級設備上的模型通常參數量較小,如4B、9B、35B-A3B、27B 等參數量,相較於雲端AI 服務的模型參數量小得多,因此模型能力會遜於雲端AI 服務
雖然本地模型通常比雲端模型參數量小,模型能力稍弱,但翻譯本身無需依賴AI 大模型過長的思考鏈路和過強的思考能力,小參數模型在翻譯場景下完全夠用,且效果足夠好,因此,本地AI 小參數模型是最具性價比的方案
推理速度
在本機運行大模型,推理速度依賴本機的硬體效能和使用的模型參數量,機器硬體配置越好、模型參數量越小,推理速度越快,但整體速度依然比不上雲端大模型API 服務
本地AI 模型運行環境
| 工具 | 特性 |
|---|---|
| Ollama | 使用簡單,快速部署使用模型 |
| LM Studio | 介面化本地模型運行環境,互動設計友好,方便使用 |
| oMLX | 專為Apple 晶片優化的本地LLM 推理環境,推理速度極快 |
Ollama
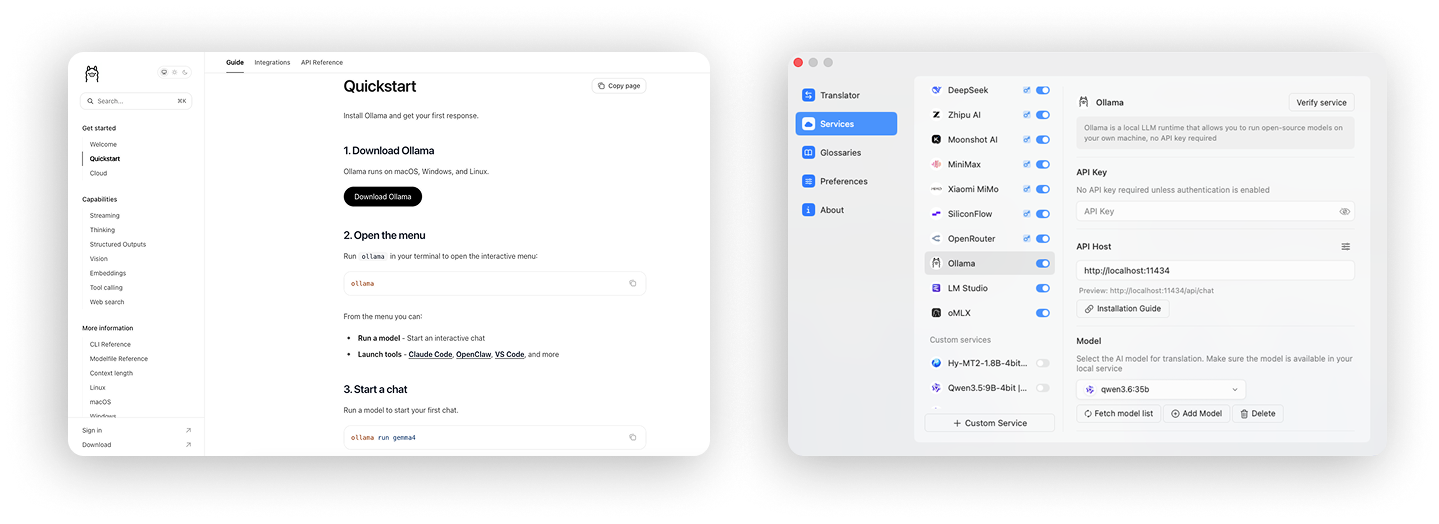
Ollama 是上手簡單的本地模型運行工具,透過命令列操作
依據官網指引安裝Ollama 之後,執行 ollama pull 模型名 下載模型
模型下載完成,且透過Ollama 成功運行後,即可在Doco Translate 中一鍵連接使用
Ollama 本機服務的預設請求位址為 http://localhost:11434
LM Studio
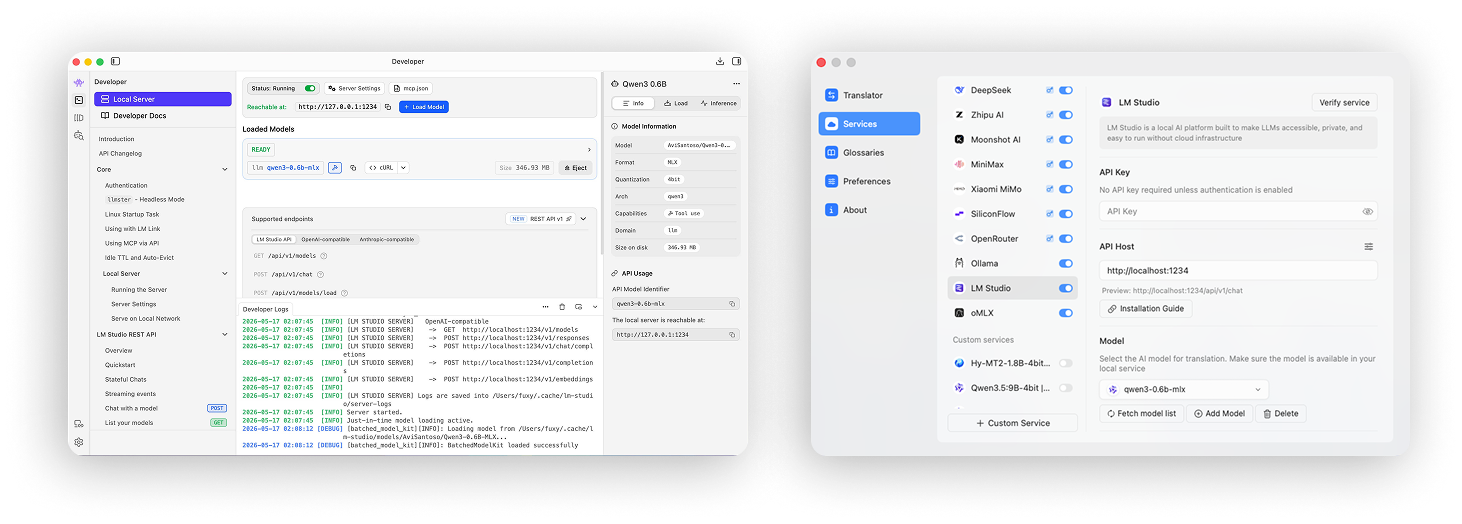
LM Studio 是一款介面化的本機模型運行工具,上手簡單介面交互
在官網下載並安裝LM Studio 之後,在應用程式內下載模型
模型下載完成後,需要開啟LM Studio 的模型服務暴露服務接口,開啟服務後即可在Doco Translate 中一鍵連接使用
LM Studio 本機服務的預設請求位址為 http://localhost:1234
oMLX
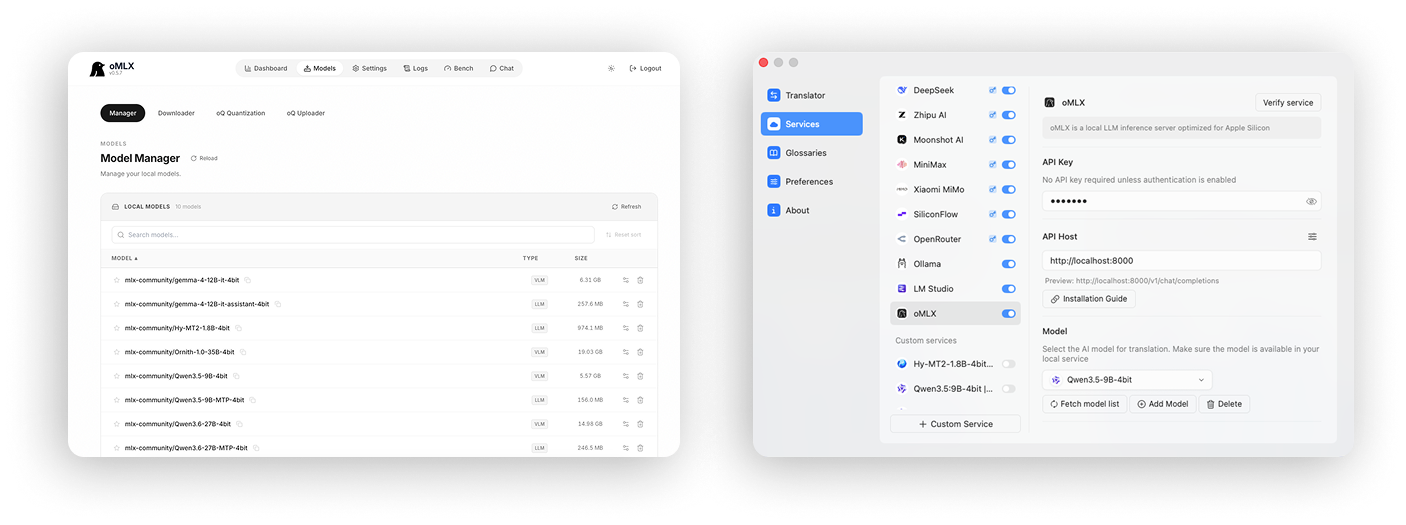
oMLX 是專為Apple 晶片優化的本地模型運行環境,模型推理速度極快
在官網下載安裝oMLX,安裝後進入oMLX 控制台,下載模型
oMLX 會自動啟動本機服務,模型下載完成後,測試可用之後即可在Doco Translate 中一鍵存取使用
oMLX 本機服務的預設請求位址為 http://localhost:8000
模型推薦
Doco Translate 官方建議使用以下模型翻譯
- Hy-MT2-1.8B:速度快,佔用記憶體極小,專為翻譯場景最佳化的模型
- Qwen3.5:9B:速度快,佔用內容稍小
- Qwen3.6:35B-A3B: 模型能力強,速度快,佔用記憶體稍大
- Gemma4:12B:較為平衡,效果、速度、記憶體佔用均較為適中
- Qwen3.6:27B: 模型能力最強,速度慢,佔用記憶體大
- Qwen3.5:4B:速度快,佔用記憶體小,穩定性稍差
大多數通用情況下建議使用 Hy-MT2-1.8B 或 Qwen3.5:9B 作為主力翻譯模型,速度快記憶體佔用小,對於有著更高翻譯品質和穩定性要求的場景,建議使用 Qwen3.6:35B-A3B,模型能力強,速度快,記憶體佔用也更大