AI 翻译服务(本地)
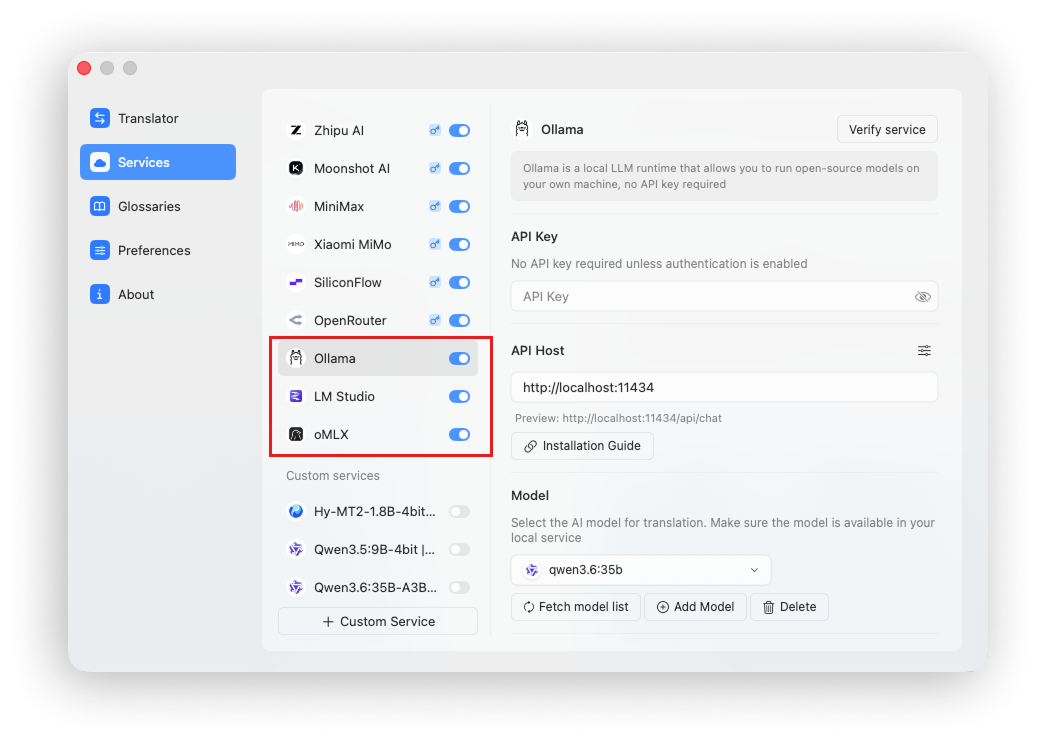
Doco Translate 支持连接本地的 AI 大模型运行环境(Ollama、LM Studio、oMLX 等),进行翻译
本地模型优势
结合本地模型使用,是 Doco Translate 最推荐的使用方式,他有几个比较显著的优势
翻译质量
AI 大语言模型最擅长解决自然语言的处理,尤其是翻译场景,效果出色,翻译质量比机器翻译引擎更好
隐私安全
通过本地运行环境加载的模型,数据不会传送到第三方服务商,所有处理都在本机进行,确保数据的绝对安全私密
成本优势
相比 API 方式调用 AI 大模型服务,不需要花钱购买 token 的费用,没有额外的经济开销
本地模型劣势
模型参数
本地模型通常是开源模型,可用于消费级设备上的模型通常参数量较小,如 4B、9B、35B-A3B、27B 等参数量,相比于云端 AI 服务的模型参数量小很多,因此模型能力会逊于云端 AI 服务
虽然本地模型通常比云端模型参数量小,模型能力稍弱,但翻译本身无需依赖 AI 大模型过长的思考链路和过强的思考能力,小参数模型在翻译场景下完全够用,且效果足够好,因此,本地 AI 小参数模型是最具性价比的方案
推理速度
在本机运行大模型,推理速度依赖本机的硬件性能和使用的模型参数量,机器硬件配置越好、模型参数量越小,推理速度越快,但整体速度依然比不上云端大模型 API 服务
本地 AI 模型运行环境
| 工具 | 特性 |
|---|---|
| Ollama | 使用简单,快速部署和使用模型 |
| LM Studio | 界面化本地模型运行环境,交互设计友好,方便使用 |
| oMLX | 专为 Apple 芯片优化的本地 LLM 推理环境,推理速度极快 |
Ollama
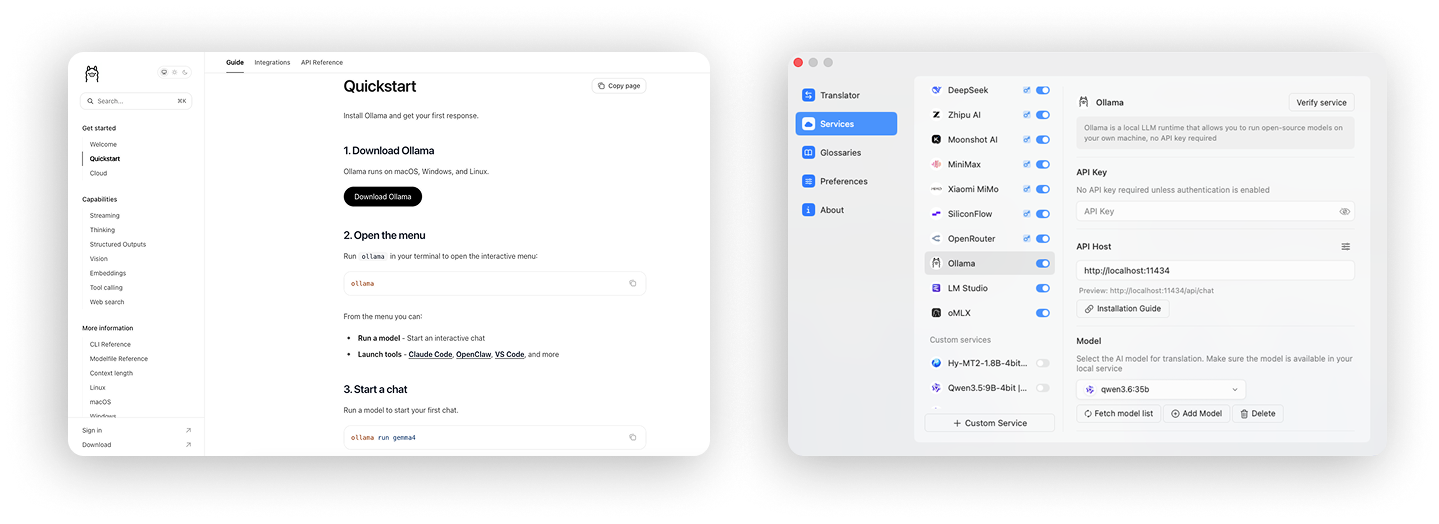
Ollama 是一个上手简单的本地模型运行工具,通过命令行操作
根据官网指引安装 Ollama 之后,执行 ollama pull 模型名 下载模型
模型下载完成,且通过 Ollama 成功运行后,即可在 Doco Translate 中一键连接使用
Ollama 本地服务的默认请求地址为 http://localhost:11434
LM Studio
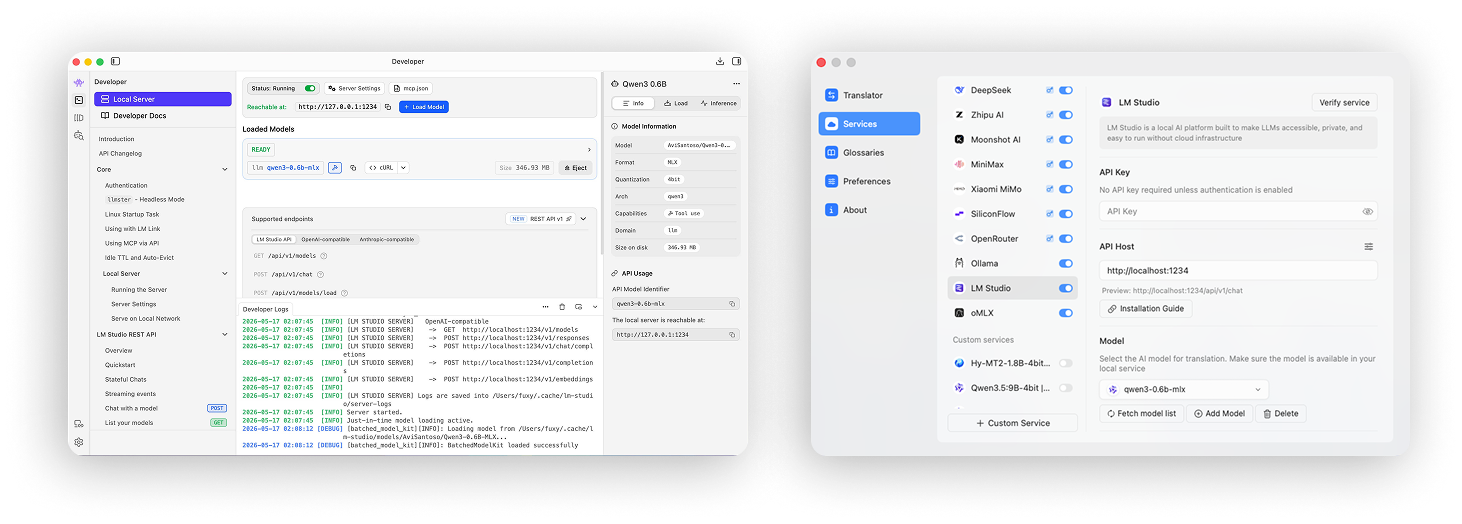
LM Studio 是一款界面化的本地模型运行工具,上手简单界面交互
在官网下载并安装 LM Studio 之后,在应用内下载模型
模型下载完成后,需要开启 LM Studio 的模型服务暴露服务接口,开启服务后即可在 Doco Translate 中一键连接使用
LM Studio 本地服务的默认请求地址为 http://localhost:1234
oMLX
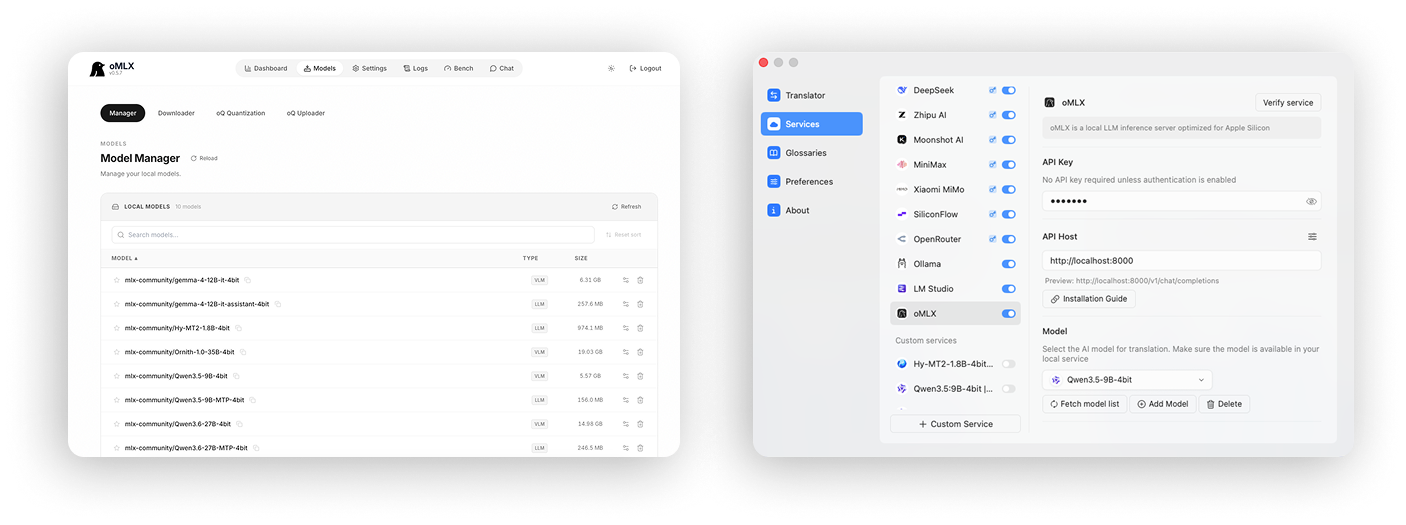
oMLX 是专为 Apple 芯片优化的本地模型运行环境,模型推理速度极快
在官网下载安装 oMLX,安装后进入 oMLX 控制台,下载模型
oMLX 会自动启动本地服务,模型下载完成后,测试可用之后即可在 Doco Translate 中一键接入使用
oMLX 本地服务的默认请求地址为 http://localhost:8000
模型推荐
Doco Translate 官方推荐使用以下模型翻译
- Hy-MT2-1.8B:速度快,占用内存极小,专为翻译场景优化的模型
- Qwen3.5:9B:速度快,占用内容稍小
- Qwen3.6:35B-A3B: 模型能力强,速度快,占用内存稍大
- Gemma4:12B:较为平衡,效果、速度、内存占用均比较适中
- Qwen3.6:27B: 模型能力最强,速度慢,占用内存大
- Qwen3.5:4B:速度快,占用内存小,稳定性稍差
大多数通用情况下推荐使用 Hy-MT2-1.8B 或 Qwen3.5:9B 作为主力翻译模型,速度快内存占用小,对于有着更高翻译质量和稳定性要求的场景,推荐使用 Qwen3.6:35B-A3B,模型能力强,速度快,内存占用也更大