Servizi IA (locali)
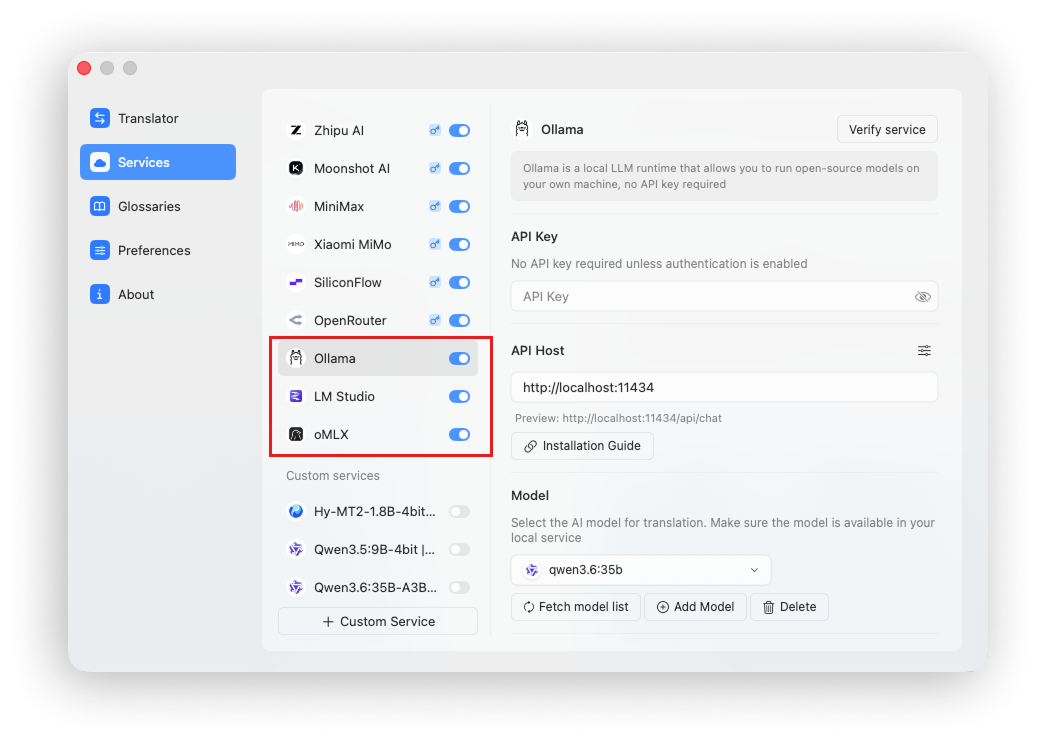
Doco Translate può connettersi ai runtime del modello AI locale come Ollama, LM Studio e oMLX per la traduzione.
Vantaggi dei modelli locali
L'utilizzo di modelli locali è l'approccio che Doco Translate consiglia vivamente perché offre numerosi vantaggi importanti.
Qualità della traduzione
I modelli linguistici di grandi dimensioni eccellono nelle attività di linguaggio naturale, in particolare nella traduzione. Di solito forniscono una qualità di traduzione migliore rispetto ai tradizionali motori di traduzione automatica.
Privacy
I modelli caricati tramite un runtime locale mantengono i tuoi dati sul tuo dispositivo. Nulla viene inviato a un fornitore di terze parti, garantendo che l'elaborazione dei documenti rimanga privata.
Costo
A differenza delle API AI cloud, i modelli locali non addebitano token e non prevedono costi di utilizzo aggiuntivi.
Limitazioni dei modelli locali
Dimensioni del modello
I modelli locali sono generalmente open source e i modelli che funzionano bene su hardware consumer spesso hanno conteggi di parametri relativamente piccoli, come 4B, 9B, 35B-A3B o 27B. Le loro capacità generali potrebbero quindi essere più deboli rispetto ai modelli cloud di grandi dimensioni.
Tuttavia, la traduzione non richiede una catena di ragionamento molto lunga o il modello di ragionamento più forte possibile. I modelli locali più piccoli sono in grado di produrre buone traduzioni, il che li rende una scelta altamente conveniente.
Velocità di inferenza
La velocità di inferenza locale dipende dall'hardware e dalle dimensioni del modello. Hardware migliore e modelli più piccoli sono più veloci, sebbene l'inferenza locale sia generalmente ancora più lenta di un'API AI cloud.
Tempi di esecuzione del modello AI locale
| Strumento | Caratteristiche |
|---|---|
| Ollama | Semplice configurazione da riga di comando e gestione dei modelli |
| LM Studio | Interfaccia grafica intuitiva per il download e l'esecuzione di modelli locali |
| oMLX | Inferenza LLM locale ad alta velocità ottimizzata per il silicio Apple |
Ollama
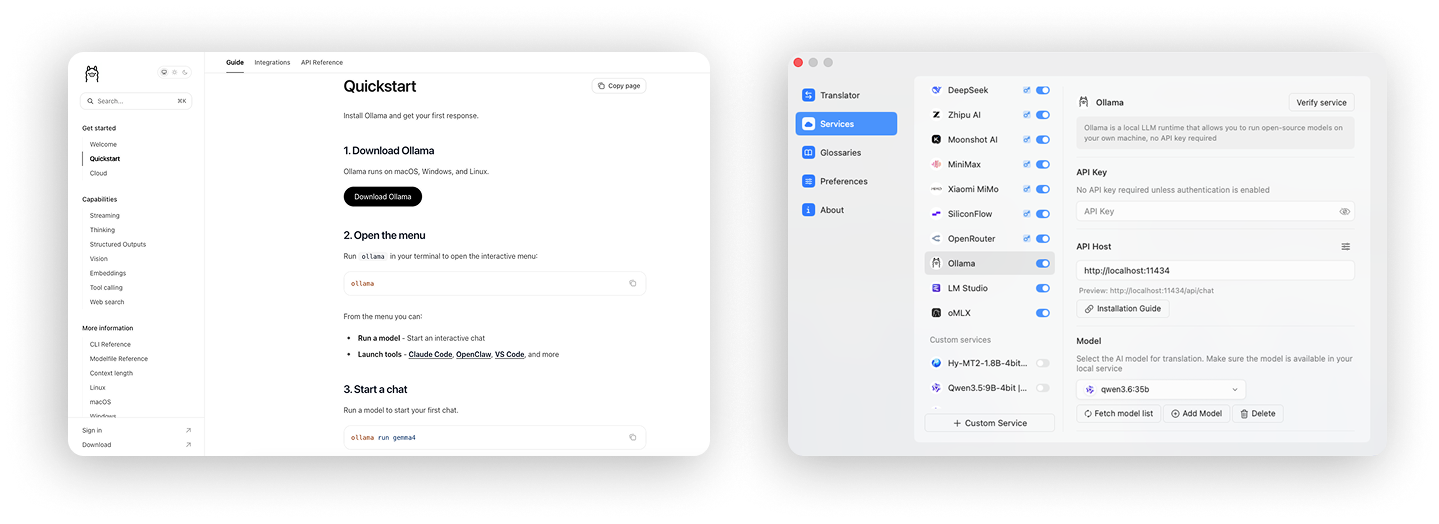
Ollama è uno strumento da riga di comando accessibile per l'esecuzione di modelli locali.
Installa Ollama seguendo le istruzioni ufficiali, quindi esegui ollama pull MODEL_NAME per scaricare un modello.
Dopo che il modello è stato scaricato e funziona correttamente in Ollama, collegalo a Doco Translate con un clic.
L'endpoint Ollama predefinito è http://localhost:11434.
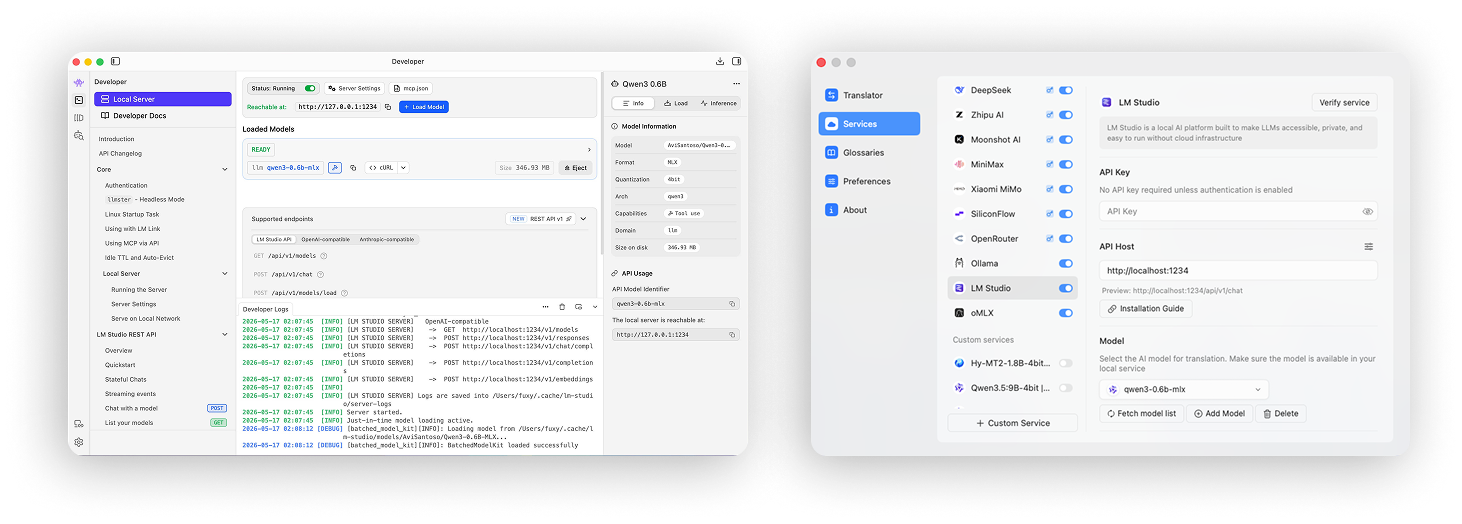
LM Studio
LM Studio fornisce un'interfaccia grafica per l'esecuzione di modelli locali ed è facile iniziare.
Installa LM Studio dal suo sito Web ufficiale, quindi scarica un modello all'interno dell'app.
Dopo aver scaricato il modello, avviare il server del modello locale di LM Studio in modo che esponga un'API. Potrai quindi collegarlo a Doco Translate con un clic.
L'endpoint predefinito di LM Studio è http://localhost:1234.
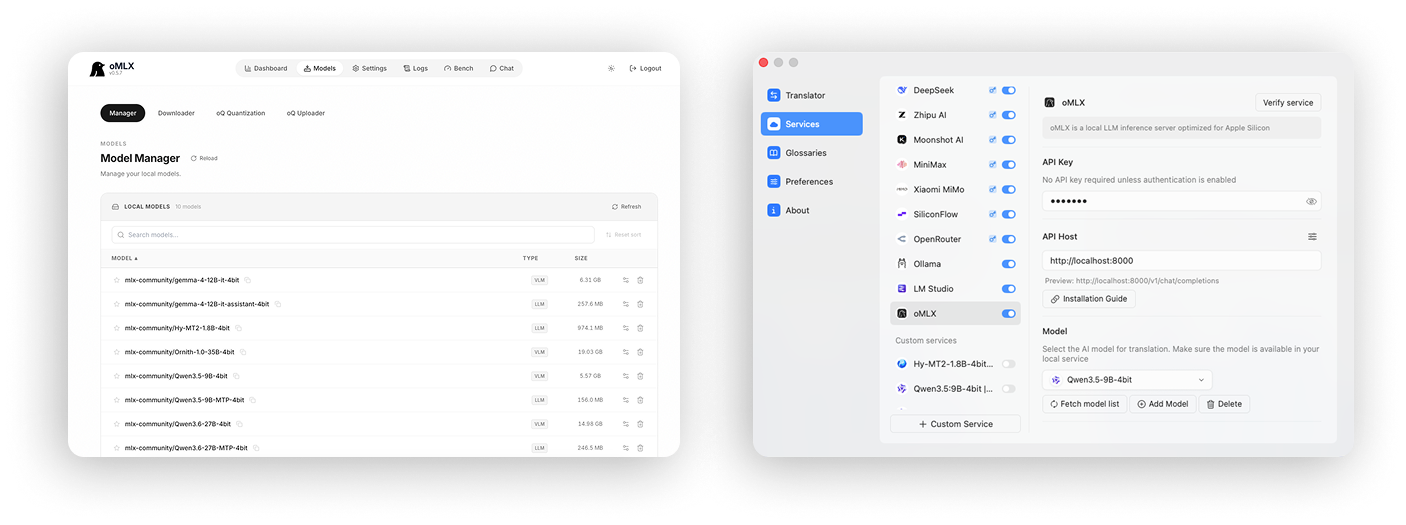
oMLX
oMLX è un runtime del modello locale ottimizzato per il silicio Apple e fornisce un'inferenza molto veloce.
Installa oMLX dal sito Web ufficiale, apri la console oMLX e scarica un modello.
oMLX avvia automaticamente il servizio locale. Dopo che il modello è stato scaricato e ha superato un test, collegalo a Doco Translate con un clic.
L'endpoint predefinito di oMLX è http://localhost:8000.
Modelli consigliati
Doco Translate consiglia i seguenti modelli per la traduzione:
- Hy-MT2-1.8B: molto veloce, utilizzo minimo di memoria e ottimizzato specificamente per la traduzione
- Qwen3.5:9B: veloce con un utilizzo di memoria relativamente basso
- Qwen3.6:35B-A3B: capacità elevate e prestazioni veloci, con un maggiore utilizzo della memoria
- Gemma4:12B: una scelta equilibrata per qualità, velocità e utilizzo della memoria
- Qwen3.6:27B: le funzionalità più potenti, ma più lente e con un uso intensivo di memoria
- Qwen3.5:4B: veloce con poco utilizzo di memoria, ma leggermente meno stabile
Per la maggior parte dei carichi di lavoro, utilizzare Hy-MT2-1.8B o Qwen3.5:9B come modello principale. Entrambi sono veloci ed efficienti in termini di memoria. Per una maggiore qualità e stabilità, utilizzare Qwen3.6:35B-A3B, che è più capace ma consuma più memoria.