AI 서비스(로컬)
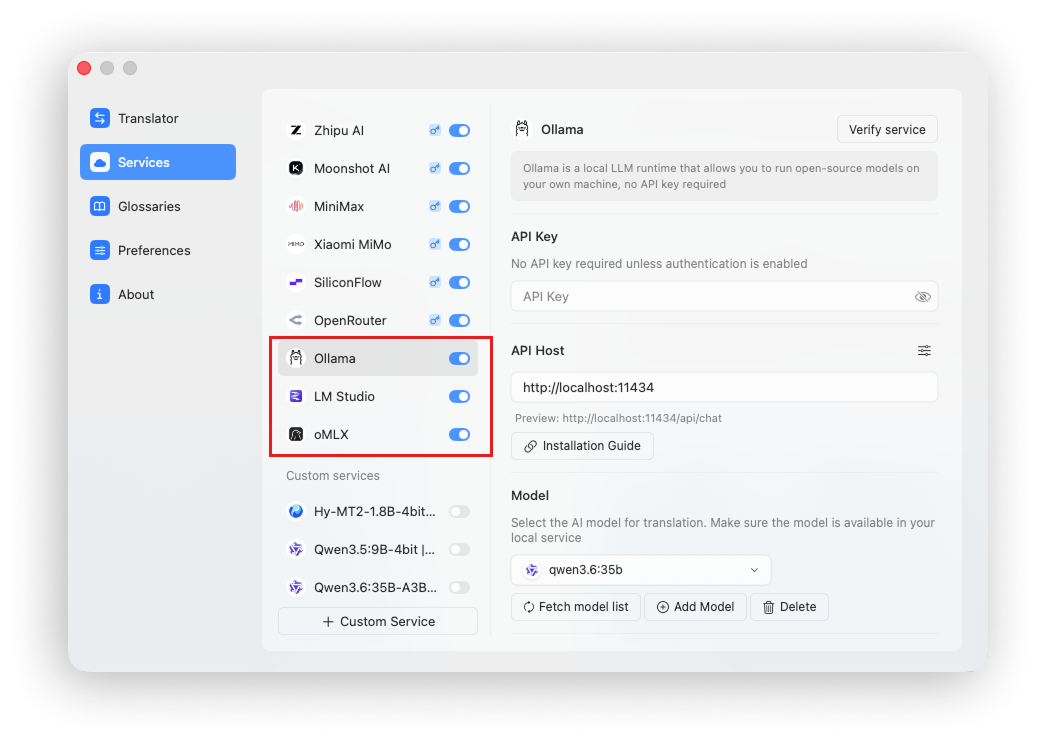
Doco Translate는 번역을 위해 Ollama, LM Studio 및 oMLX와 같은 로컬 AI 모델 런타임에 연결할 수 있습니다.
현지 모델의 장점
로컬 모델을 사용하는 것은 몇 가지 중요한 이점을 제공하기 때문에 Doco Translate가 가장 강력하게 권장하는 접근 방식입니다.
번역 품질
대형 언어 모델은 자연어 작업, 특히 번역에 탁월합니다. 일반적으로 기존 기계 번역 엔진보다 더 나은 번역 품질을 제공합니다.
개인정보 보호로컬 런타임을 통해 로드된
Model은 데이터를 장치에 유지합니다. 문서 처리가 비공개로 유지되도록 아무 것도 제3자 제공업체로 전송되지 않습니다.
비용
클라우드 AI API와 달리 로컬 모델은 토큰 비용을 청구하지 않으며 추가 사용 요금도 없습니다.
로컬 모델의 한계
모델 사이즈
Local 모델은 일반적으로 오픈 소스이며 소비자 하드웨어에서 잘 실행되는 모델은 4B, 9B, 35B-A3B 또는 27B와 같이 상대적으로 작은 매개변수 개수를 갖는 경우가 많습니다. 따라서 일반적인 기능은 대규모 클라우드 모델보다 약할 수 있습니다.
그러나 번역에는 매우 긴 추론 체인이나 가장 강력한 추론 모델이 필요하지 않습니다. 더 작은 로컬 모델은 좋은 번역을 생성할 수 있으므로 매우 비용 효과적인 선택이 됩니다.
추론 속도
로컬 추론 속도는 하드웨어와 모델 크기에 따라 다릅니다. 더 나은 하드웨어와 더 작은 모델은 더 빠르지만 로컬 추론은 일반적으로 클라우드 AI API보다 여전히 느립니다.
로컬 AI 모델 런타임
| 도구 | 특성 |
|---|---|
| 올라마 | 간단한 명령줄 설정 및 모델 관리 |
| LM 스튜디오 | 로컬 모델을 다운로드하고 실행할 수 있는 친숙한 그래픽 인터페이스 |
| oMLX | Apple Silicon에 최적화된 고속 로컬 LLM 추론 |
올라마
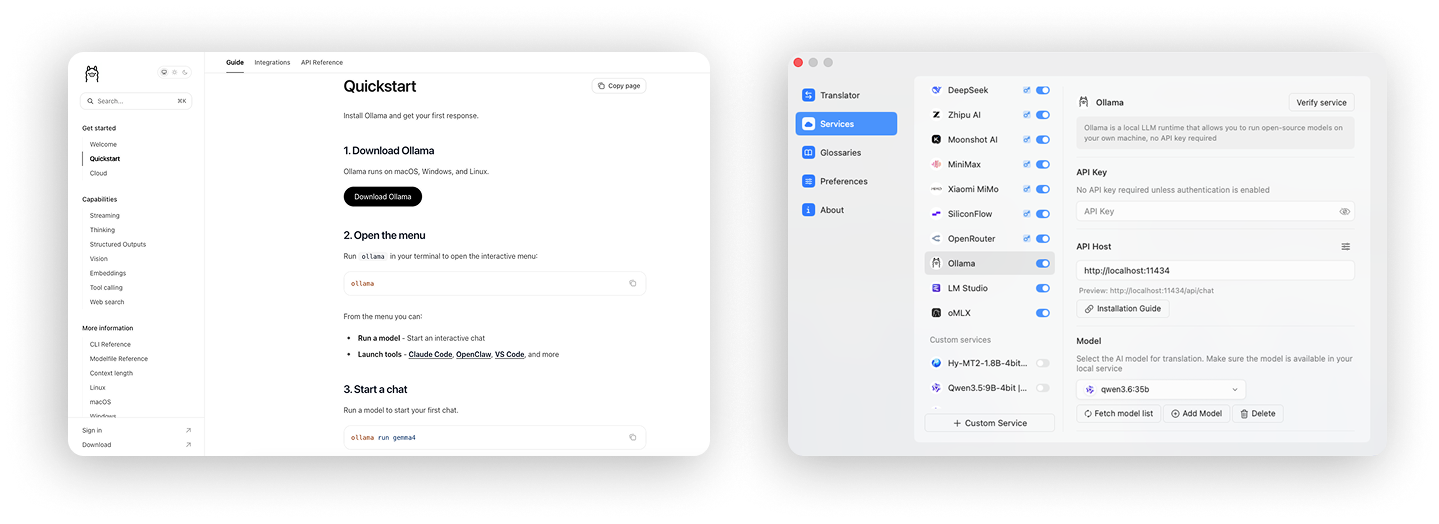
Ollama는 로컬 모델을 실행하기 위한 접근 가능한 명령줄 도구입니다.
공식 지침에 따라 Ollama를 설치한 후 다음을 실행하세요. ollama pull MODEL_NAME 모델을 다운로드합니다.
모델을 다운로드하고 Ollama에서 성공적으로 실행한 후 한 번의 클릭으로 Doco Translate에 연결합니다.
기본 Ollama 엔드포인트는 다음과 같습니다. http://localhost:11434.
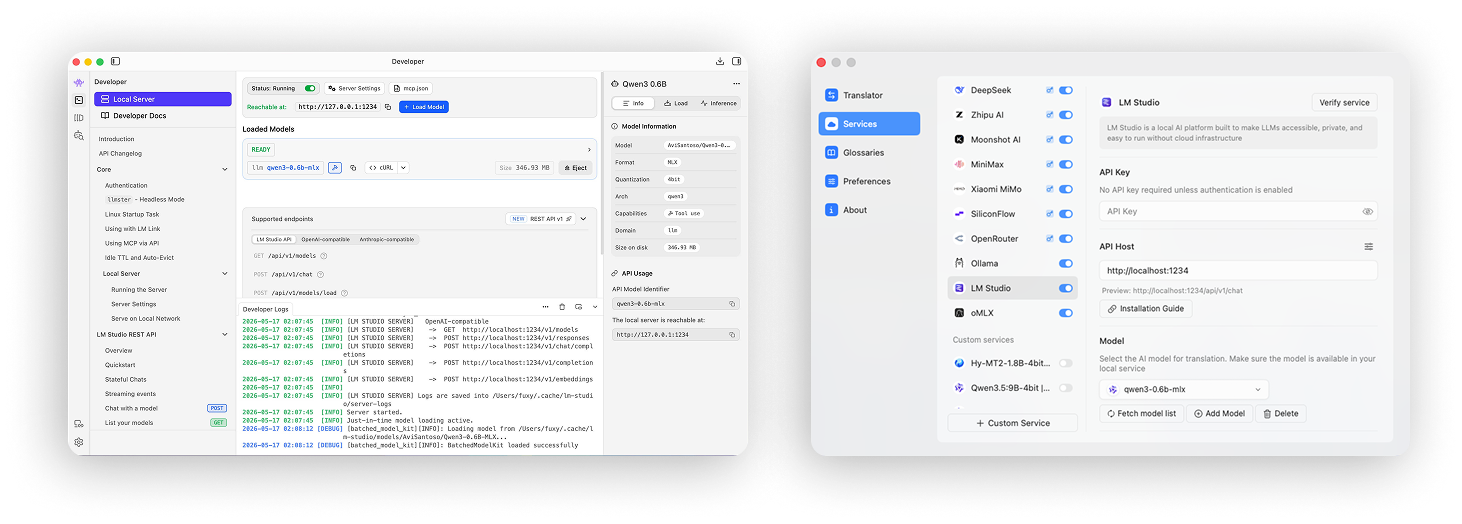
LM 스튜디오
LM Studio는 로컬 모델 실행을 위한 그래픽 인터페이스를 제공하며 시작하기 쉽습니다.
공식 웹사이트에서 LM Studio를 설치한 후 앱 내에서 모델을 다운로드하세요.
모델을 다운로드한 후 LM Studio의 로컬 모델 서버를 시작하여 API를 노출합니다. 그런 다음 한 번의 클릭으로 Doco Translate에 연결할 수 있습니다.
기본 LM Studio 엔드포인트는 다음과 같습니다. http://localhost:1234.
oMLX
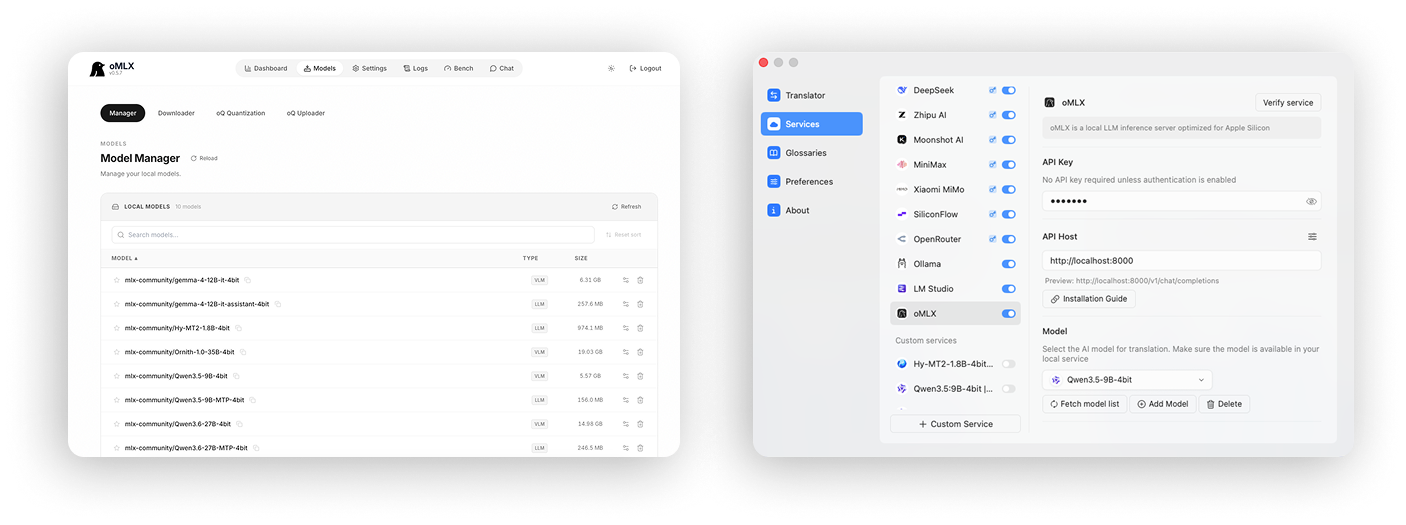
oMLX는 Apple Silicon에 최적화된 로컬 모델 런타임이며 매우 빠른 추론을 제공합니다.
공식 웹사이트에서 oMLX를 설치하고 oMLX 콘솔을 열고 모델을 다운로드하세요.
oMLX는 로컬 서비스를 자동으로 시작합니다. 모델을 다운로드하고 테스트를 통과한 후 한 번의 클릭으로 Doco Translate에 연결합니다.
기본 oMLX 엔드포인트는 다음과 같습니다. http://localhost:8000.
추천 모델
Doco Translate는 번역을 위해 다음 모델을 권장합니다.
- Hy-MT2-1.8B: 매우 빠르고 메모리 사용량이 최소화되며 번역에 특별히 최적화되었습니다.
- Qwen3.5:9B: 상대적으로 메모리 사용량이 적고 빠릅니다.
- Qwen3.6:35B-A3B: 강력한 기능과 빠른 성능, 더 높은 메모리 사용
- Gemma4:12B: 품질, 속도, 메모리 사용의 균형 잡힌 선택
- Qwen3.6:27B: 가장 강력한 기능을 제공하지만 느리고 메모리 집약적입니다.
- Qwen3.5:4B: 메모리 사용량이 적어 빠르지만 안정성이 약간 떨어집니다.
대부분의 워크로드에는 다음을 사용하세요. Hy-MT2-1.8B 또는 Qwen3.5:9B 가 기본 모델입니다. 둘 다 빠르고 메모리 효율적입니다. 더 높은 품질과 안정성을 위해 다음을 사용하세요. Qwen3.6:35B-A3B는 더 많은 기능을 제공하지만 더 많은 메모리를 소비합니다.