스캔한 PDF 번역
Doco Translate에는 스캔한 PDF를 구문 분석하고 번역하기 위한 OCR이 포함되어 있습니다.
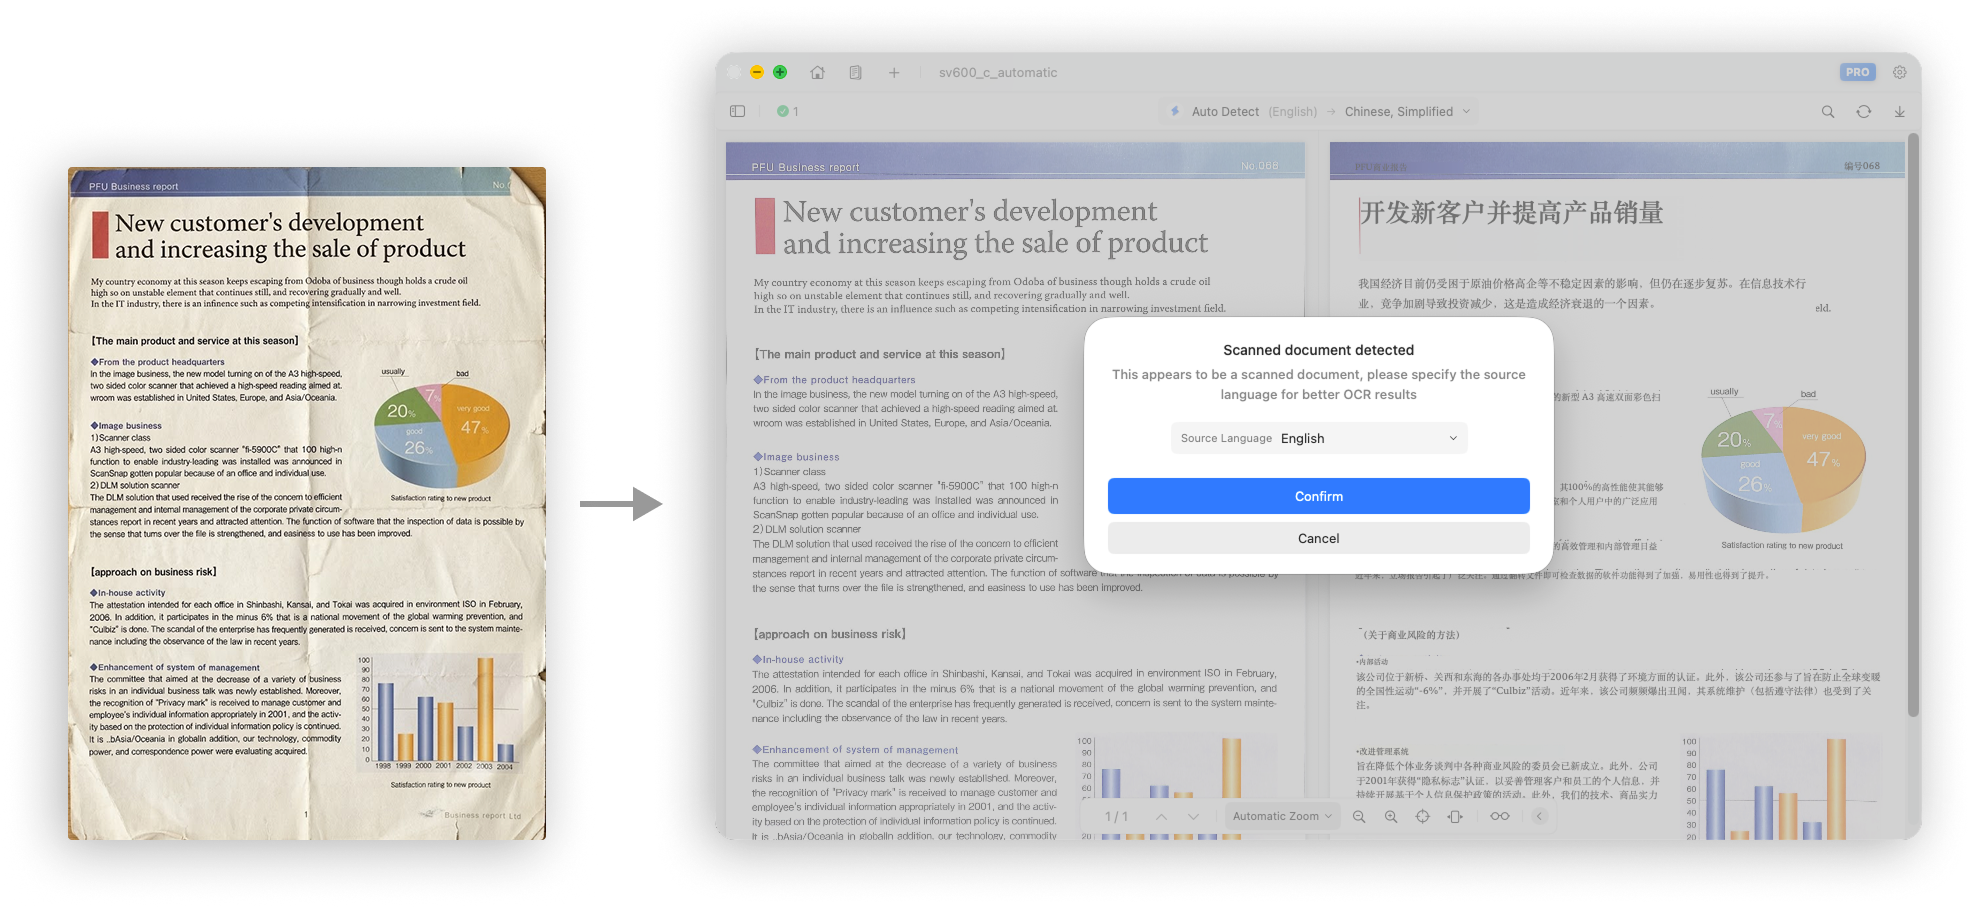
스캔한 PDF에서 각 페이지는 일반적으로 구조화된 텍스트 대신 이미지로 저장됩니다. 텍스트를 직접 추출할 수 없기 때문에 OCR은 텍스트를 번역하기 전에 먼저 텍스트를 인식하고 추출해야 합니다. 스캔한 PDF에 대한
중요 사항
스캔된 문서는 시각적으로 인식되며 언어 식별에 도움이 될 수 있는 원본 텍스트 메타데이터를 포함하지 않습니다. 소스 언어가 다음으로 설정된 경우 자동 감지, 텍스트 인식 및 추출의 정확성이 떨어질 수 있습니다.
스캔한 문서의 모범 사례는 다음과 같습니다. 원본 언어를 수동으로 선택하세요. 올바른 언어를 선택하면 텍스트 추출과 OCR 정확도가 모두 향상됩니다.
Doco Translate가 스캔한 문서를 감지하면 OCR 및 번역 결과를 개선하기 위해 소스 언어를 수동으로 선택하라는 메시지도 표시됩니다.