AI (lokalne)
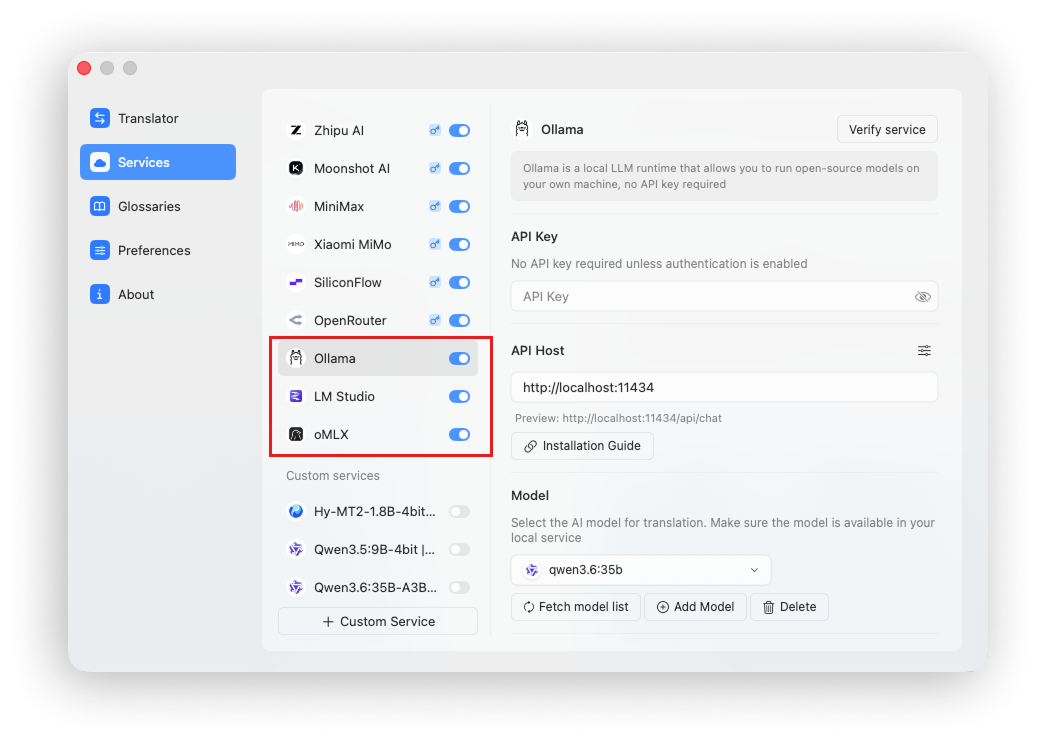
Doco Translate może łączyć się z lokalnymi środowiskami wykonawczymi modeli AI, takimi jak Ollama, LM Studio i oMLX w celu tłumaczenia.
Alety modeli lokalnych
Użycie modeli lokalnych to podejście, które Doco Translate zaleca najbardziej, ponieważ oferuje kilka ważnych korzyści.
Jakość tłumaczenia
Duże modele językowe doskonale sprawdzają się w zadaniach związanych z językiem naturalnym, zwłaszcza w tłumaczeniach. Zwykle zapewniają lepszą jakość tłumaczenia niż konwencjonalne silniki tłumaczenia maszynowego.
Prywatność
Modele ładowane przez lokalne środowisko wykonawcze przechowują Twoje dane na Twoim urządzeniu. Nic nie jest wysyłane do zewnętrznego dostawcy, dzięki czemu przetwarzanie dokumentów pozostaje prywatne.
Koszt
W przeciwieństwie do interfejsów API AI w chmurze, modele lokalne nie pobierają opłat za tokeny i nie mają dodatkowych opłat za użytkowanie.
Ograniczenia modeli lokalnych
Rozmiar modelu
Local modele są zazwyczaj typu open source, a modele dobrze działające na sprzęcie konsumenckim często mają stosunkowo małą liczbę parametrów, np. 4B, 9B, 35B-A3B lub 27B. Ich ogólne możliwości mogą być zatem słabsze niż w przypadku dużych modeli chmurowych.
Jednak tłumaczenie nie wymaga bardzo długiego łańcucha rozumowania ani najsilniejszego możliwego modelu rozumowania. Mniejsze modele lokalne są w stanie zapewnić dobre tłumaczenia, co czyni je wysoce opłacalnym wyborem.
Prędkość wnioskowania
Lokalna prędkość wnioskowania zależy od sprzętu i rozmiaru modelu. Lepszy sprzęt i mniejsze modele są szybsze, chociaż wnioskowanie lokalne jest generalnie nadal wolniejsze niż interfejs API AI w chmurze.
Lokalne środowiska wykonawcze modelu AI
| Narzędzie | Charakterystyka |
|---|---|
| Ollama | Prosta konfiguracja w wierszu poleceń i zarządzanie modelami |
| LM | Przyjazny interfejs graficzny do pobierania i uruchamiania modeli lokalnych |
| oMLX | Szybkie lokalne wnioskowanie LLM zoptymalizowane pod kątem krzemu Apple |
Ollama
Ollama to przystępne narzędzie wiersza poleceń do uruchamiania modeli lokalnych.
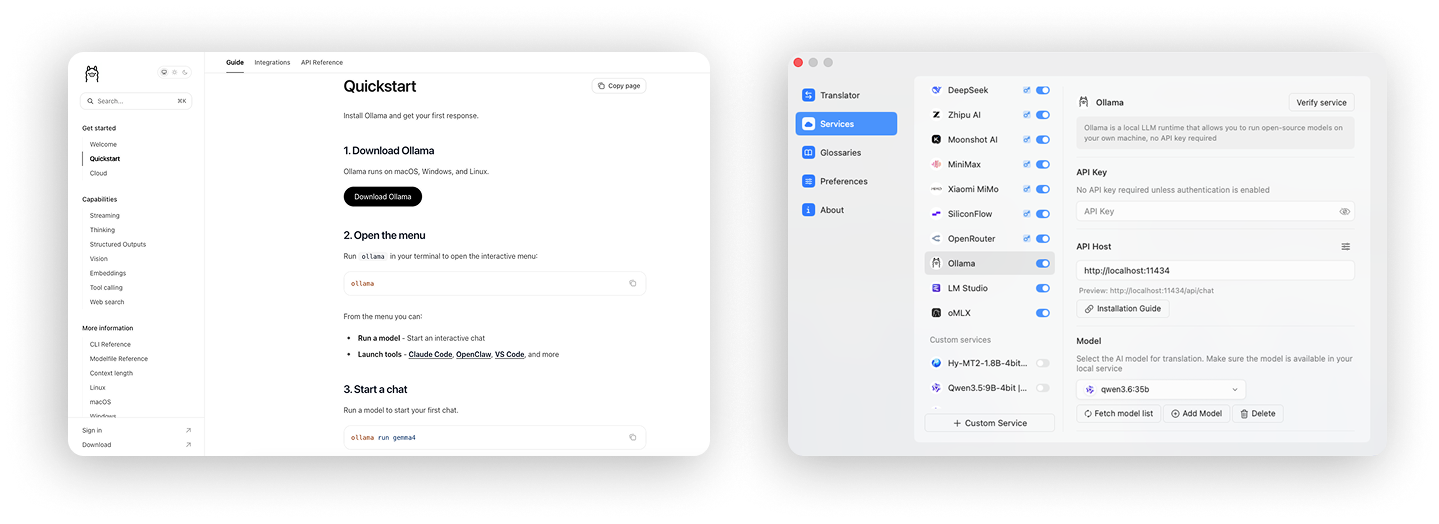
Zainstaluj Ollamę, postępując zgodnie z jego oficjalnymi instrukcjami, a następnie uruchom ollama pull MODEL_NAME aby pobrać model.
Po pobraniu modelu i pomyślnym uruchomieniu w Ollama, połącz go jednym kliknięciem z Doco Translate.
Domyślny endpoint Ollama to http://localhost:11434.
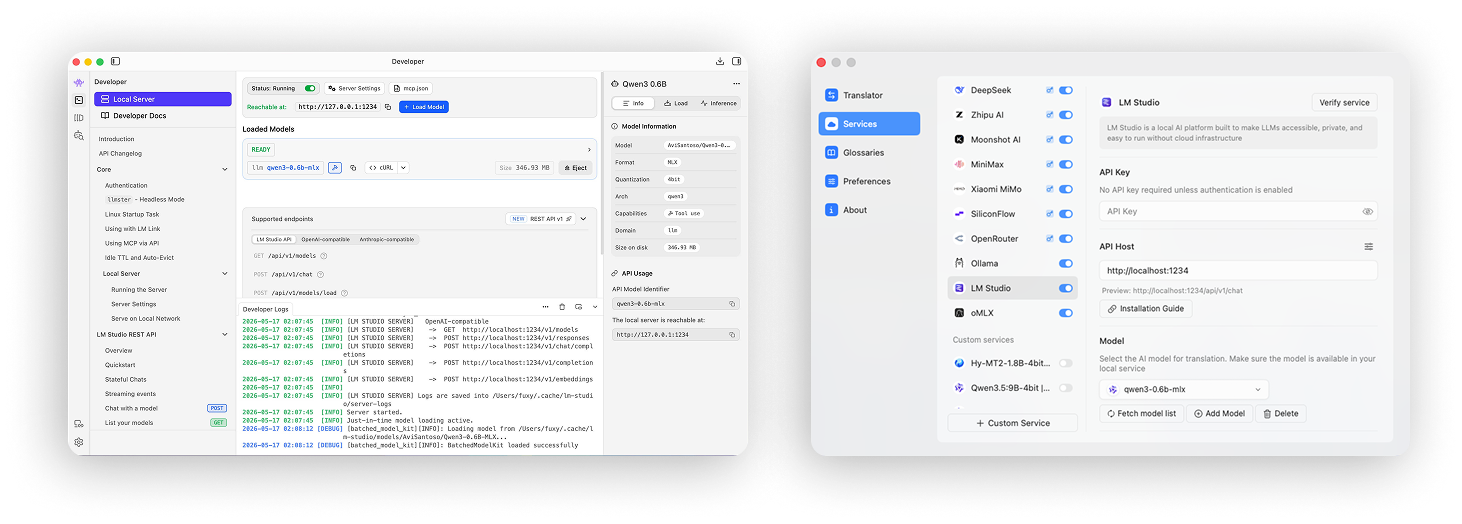
LM
LM Studio zapewnia interfejs graficzny do uruchamiania modeli lokalnych i jest łatwy w obsłudze.
Zainstaluj LM Studio z jego oficjalnej strony internetowej, a następnie pobierz model w aplikacji.
Po pobraniu modelu uruchom lokalny serwer modeli LM Studio, aby udostępnił interfejs API. Następnie możesz jednym kliknięciem połączyć go z Doco Translate.
Domyślny punkt końcowy LM Studio to http://localhost:1234.
oMLX
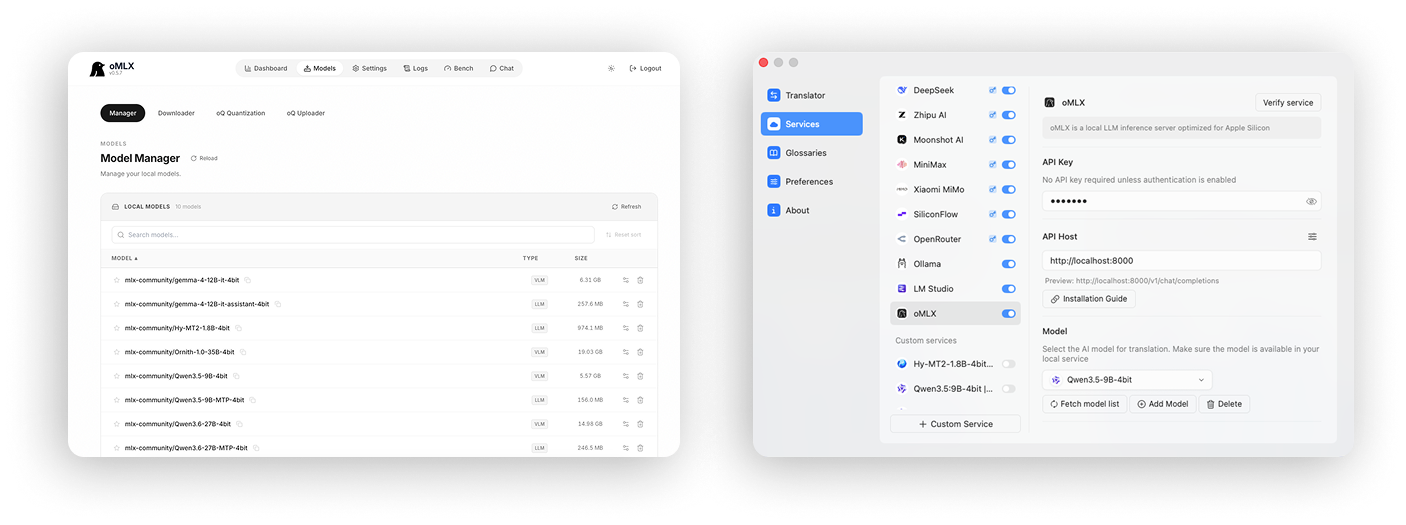
oMLX to środowisko uruchomieniowe modelu lokalnego zoptymalizowane pod kątem krzemu Apple i zapewniające bardzo szybkie wnioskowanie.
Zainstaluj oMLX z oficjalnej strony internetowej, otwórz konsolę oMLX i pobierz model.
oMLX automatycznie uruchamia usługę lokalną. Po pobraniu modelu i przejściu testu jednym kliknięciem podłącz go do Doco Translate.
Domyślny endpoint oMLX to http://localhost:8000.
Zalecane modele
Doco Translate zaleca do tłumaczenia następujące modele:
- Hy-MT2-1.8B: bardzo szybki, minimalne zużycie pamięci i zoptymalizowany specjalnie pod kątem tłumaczenia
- Qwen3.5:9B: szybki przy stosunkowo niskim zużyciu pamięci
- Qwen3.6:35B-A3B: duże możliwości i duża wydajność przy większym zużyciu pamięci
- Gemma4:12B: zrównoważony wybór pod względem jakości, szybkości i wykorzystania pamięci
- Qwen3.6:27B: największe możliwości, ale wolniejsze i wymagające dużej ilości pamięci
- Qwen3.5:4B: szybki przy niskim zużyciu pamięci, ale nieco mniej stabilny
W przypadku większości obciążeń użyj Hy-MT2-1.8B lub Qwen3.5:9B as jest modelem podstawowym. Obydwa są szybkie i wydajne pod względem pamięci. Aby uzyskać wyższą jakość i stabilność, użyj Qwen3.6:35B-A3B, który ma większe możliwości, ale zużywa więcej pamięci.