Tłumacz zeskanowane pliki PDF
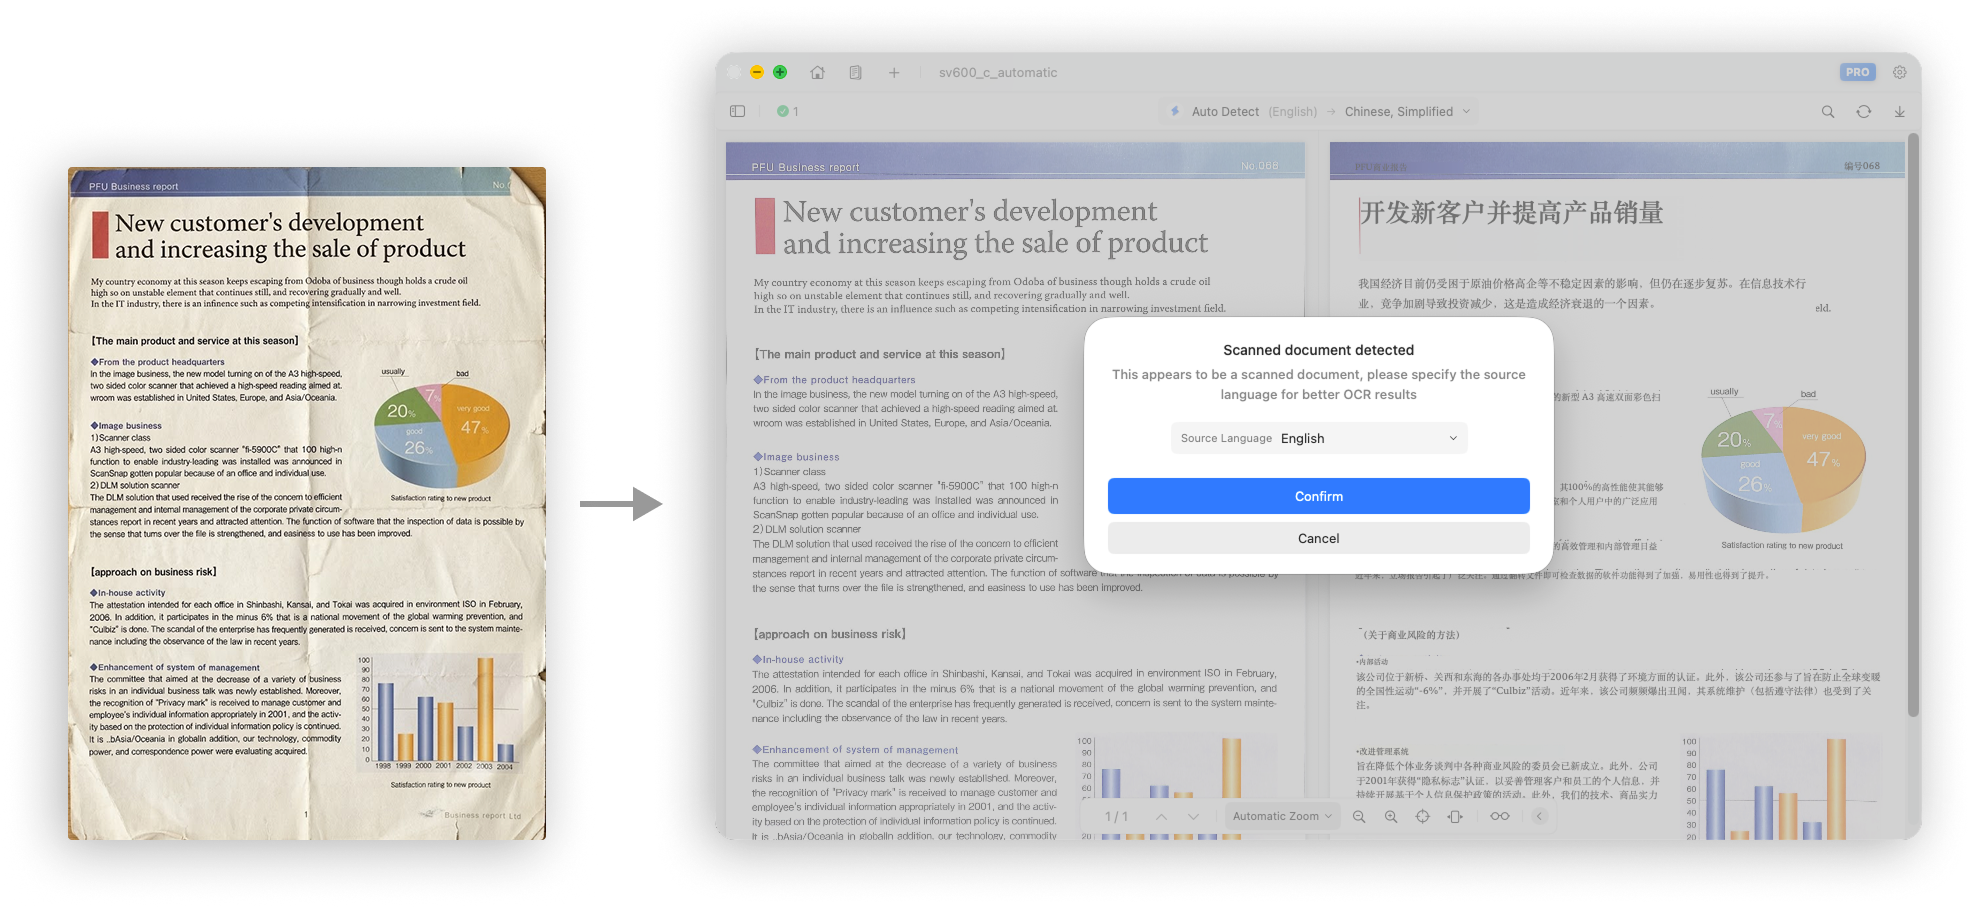
Doco Translate zawiera funkcję OCR do analizowania i tłumaczenia zeskanowanych plików PDF.
W zeskanowanym pliku PDF każda strona jest zwykle zapisywana jako obraz, a nie jako tekst strukturalny. Ponieważ tekstu nie można wyodrębnić bezpośrednio, funkcja OCR musi najpierw rozpoznać i wyodrębnić tekst, zanim będzie można go przetłumaczyć. Tłumaczenie
Ważne uwagi
Zeskanowane dokumenty są rozpoznawane wizualnie i nie zawierają oryginalnych metadanych tekstowych, które mogłyby pomóc w identyfikacji języka. Jeśli język źródłowy jest ustawiony na Automatyczne wykrywanie, rozpoznawanie i wyodrębnianie tekstu może być mniej dokładne.
Najlepszą praktyką w przypadku zeskanowanych dokumentów jest: Wybierz ręcznie język źródłowy. Wybór odpowiedniego języka poprawia zarówno ekstrakcję tekstu, jak i dokładność OCR.
Gdy Doco Translate wykryje zeskanowany dokument, wyświetli się także monit o ręczny wybór języka źródłowego w celu poprawy wyników OCR i tłumaczenia.