Сервисы ИИ (локальные)
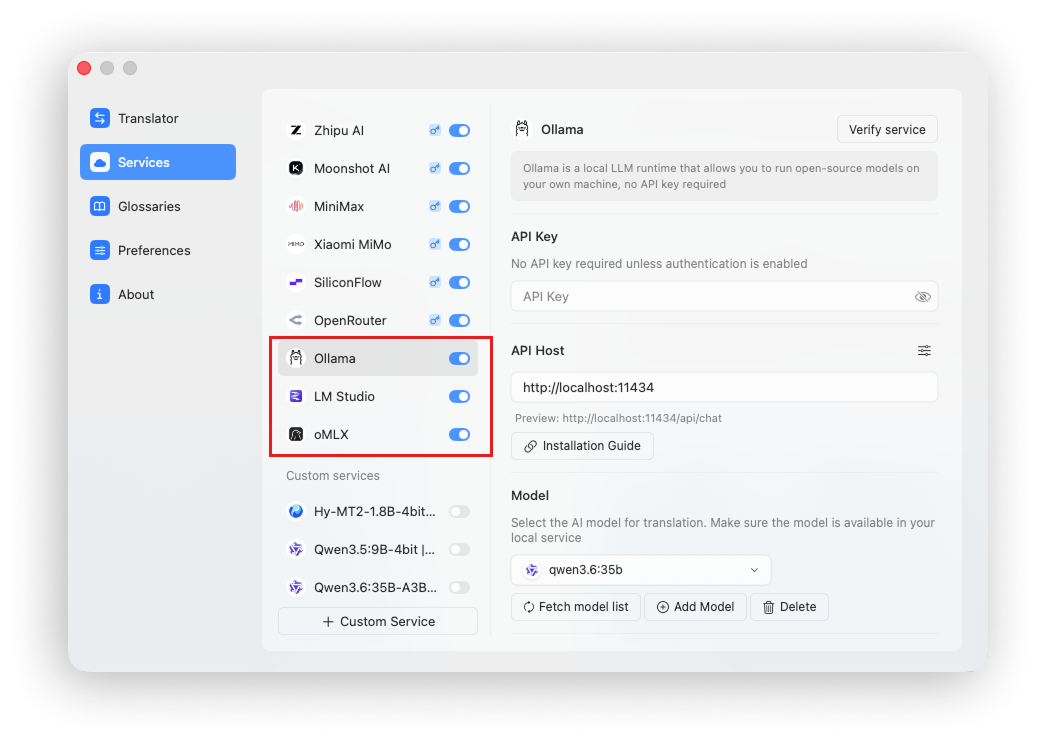
Doco Translate может подключаться к локальным средам выполнения моделей искусственного интеллекта, таким как Ollama, LM Studio и oMLX, для перевода.
Преимущества локальных моделей
Использование локальных моделей — это подход, который Doco Translate рекомендует наиболее настоятельно, поскольку он дает несколько важных преимуществ.
Качество перевода
Большие языковые модели превосходно справляются с задачами на естественном языке, особенно с переводом. Обычно они обеспечивают лучшее качество перевода, чем обычные системы машинного перевода.
Конфиденциальность
Модели, загруженные через локальную среду выполнения, сохраняют ваши данные на вашем устройстве. Стороннему поставщику ничего не отправляется, что гарантирует конфиденциальность обработки документов.
Стоимость
В отличие от облачных API AI, локальные модели не взимают плату за токены и не взимают дополнительную плату за использование.
Ограничения локальных моделей
Размер модели
Локальные модели обычно имеют открытый исходный код, а модели, которые хорошо работают на потребительском оборудовании, часто имеют относительно небольшое количество параметров, например 4B, 9B, 35B-A3B или 27B. Поэтому их общие возможности могут быть слабее, чем у больших облачных моделей.
Однако для перевода не требуется очень длинная цепочка рассуждений или максимально надежная модель рассуждения. Небольшие местные модели способны выполнять хорошие переводы, что делает их весьма экономически эффективным выбором.
Скорость вывода
Скорость локального вывода зависит от вашего оборудования и размера модели. Лучшее оборудование и модели меньшего размера работают быстрее, хотя локальный вывод, как правило, все же медленнее, чем облачный AI API.
Локальные среды выполнения моделей ИИ
| Инструмент | Характеристики |
|---|---|
| Оллама | Простая настройка и управление моделями из командной строки |
| LM Студия | Дружественный графический интерфейс для загрузки и запуска локальных моделей |
| oMLX | Высокоскоростной локальный вывод LLM, оптимизированный для процессоров Apple |
Оллама
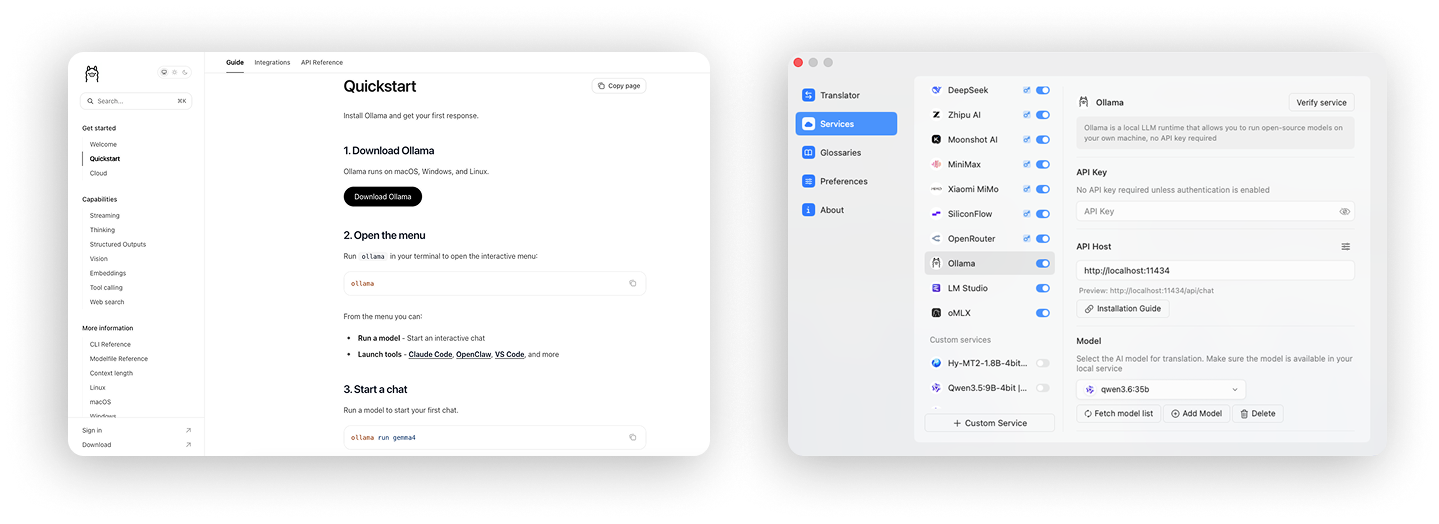
Ollama — это доступный инструмент командной строки для запуска локальных моделей.
Установите Ollama, следуя официальным инструкциям, затем запустите ollama pull MODEL_NAME , чтобы скачать модель.
После того, как модель загрузится и успешно заработает в Олламе, подключите ее к Doco Translate одним щелчком мыши.
Конечная точка Олламы по умолчанию: http://localhost:11434.
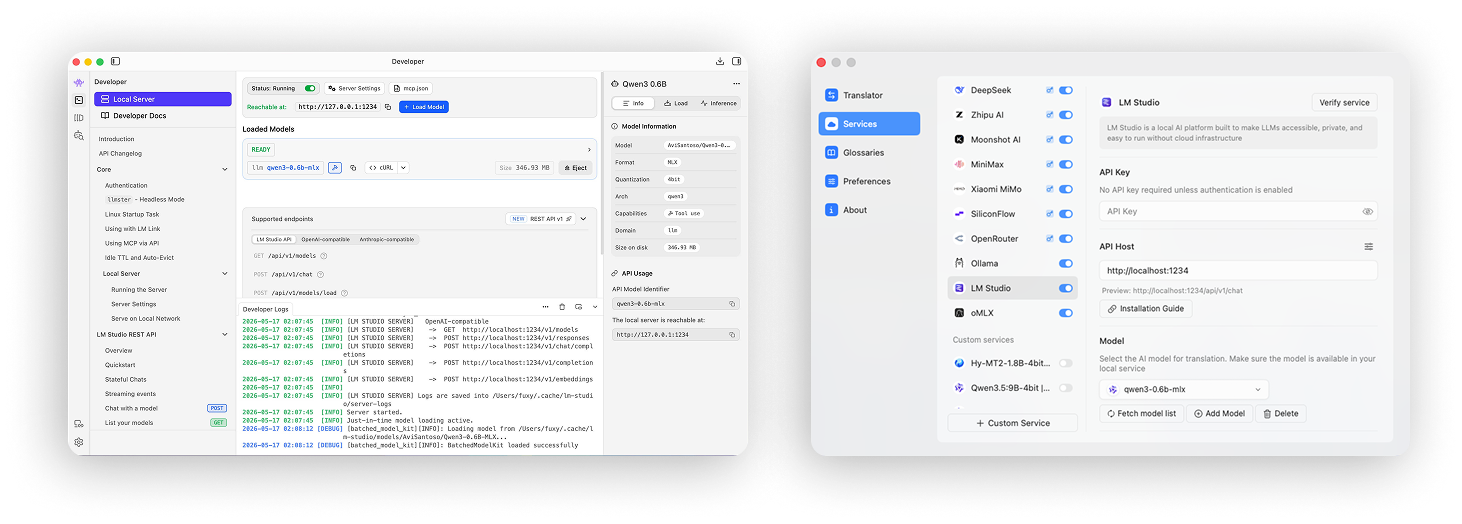
LM Студия
LM Studio предоставляет графический интерфейс для запуска локальных моделей, и с ним легко начать работу.
Установите LM Studio с официального сайта, затем загрузите модель внутри приложения.
После загрузки модели запустите локальный сервер модели LM Studio, чтобы он предоставил API. Затем вы можете подключить его к Doco Translate одним щелчком мыши.
Конечная точка LM Studio по умолчанию: http://localhost:1234.
oMLX
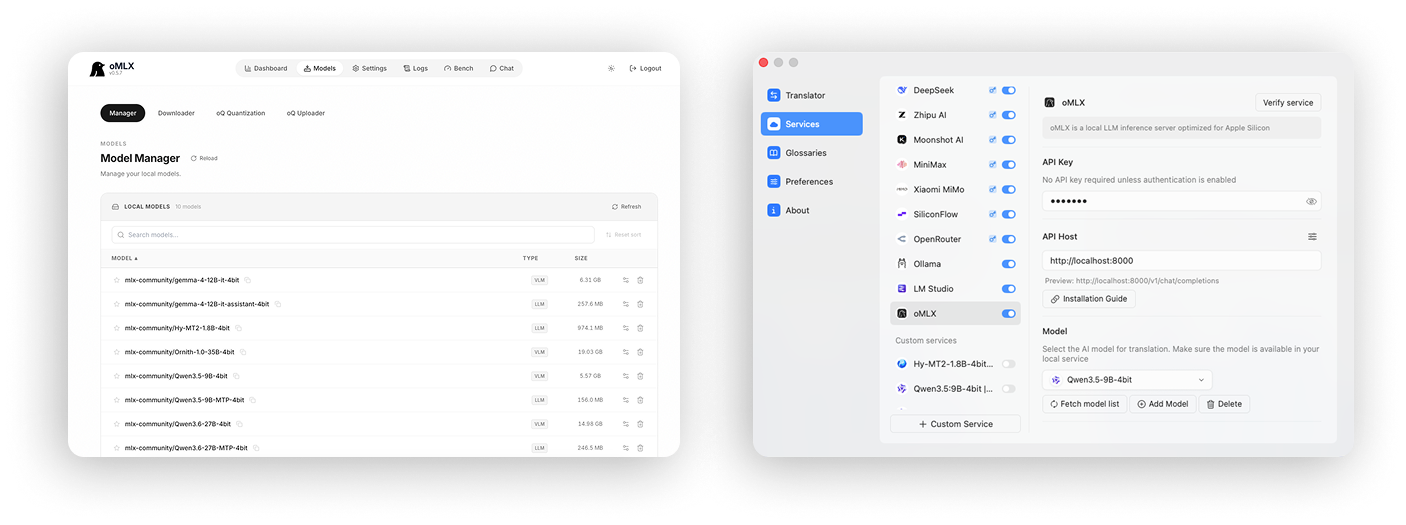
oMLX — это среда выполнения локальной модели, оптимизированная для процессоров Apple и обеспечивающая очень быстрый вывод.
Установите oMLX с официального сайта, откройте консоль oMLX и загрузите модель.
oMLX автоматически запускает локальную службу. После того, как модель загрузилась и прошла тестирование, подключите ее к Doco Translate одним щелчком мыши.
Конечная точка oMLX по умолчанию: http://localhost:8000.
Рекомендуемые модели
Doco Translate рекомендует для перевода следующие модели:
- Hy-MT2-1.8B: очень быстрый, требует минимального использования памяти и оптимизирован специально для перевода.
- Qwen3.5:9B: быстрый, с относительно низким использованием памяти.
- Qwen3.6:35B-A3B: широкие возможности и высокая производительность с более высоким использованием памяти.
- Gemma4:12B: сбалансированный выбор по качеству, скорости и использованию памяти.
- Qwen3.6:27B: самые сильные возможности, но медленнее и требовательнее к памяти.
- Qwen3.5:4B: быстрый, с низким использованием памяти, но немного менее стабильный.
Для большинства рабочих нагрузок используйте Hy-MT2-1.8B или Qwen3.5:9B является основной моделью. Оба работают быстро и эффективно используют память. Для более высокого качества и стабильности используйте Qwen3.6:35B-A3B, который более эффективен, но потребляет больше памяти.