Перевести отсканированные PDF-файлы
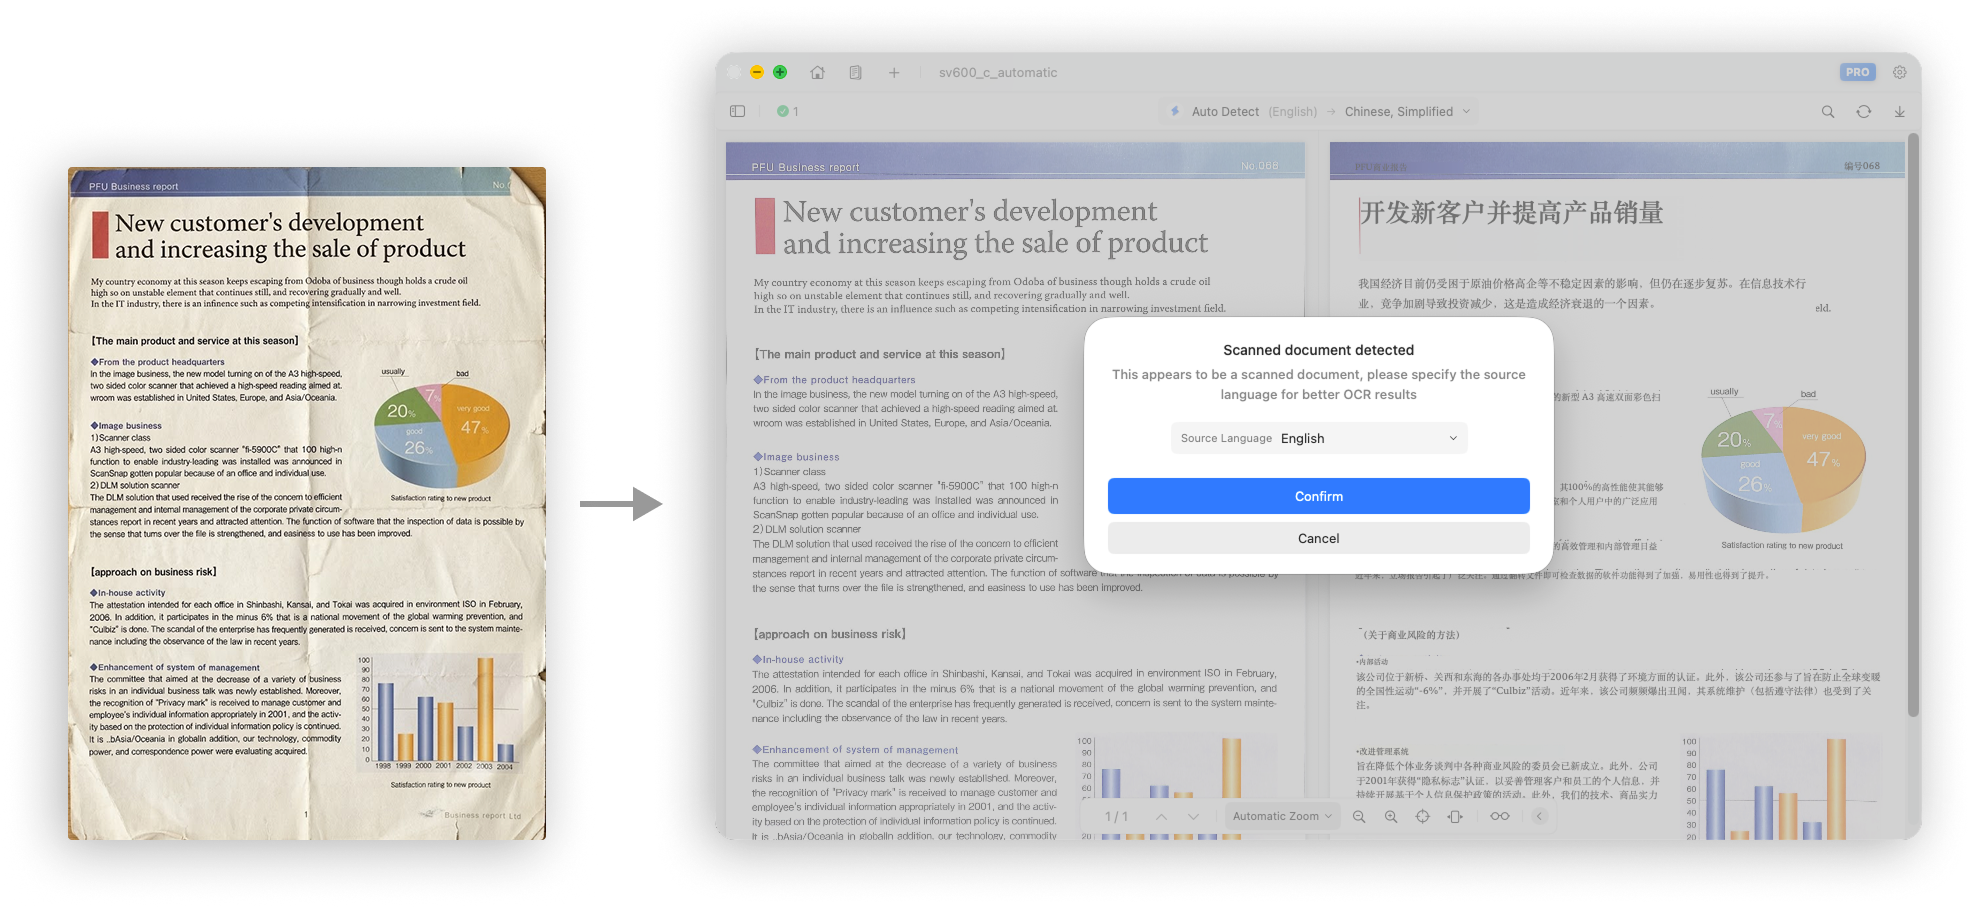
Doco Translate включает OCR для анализа и перевода отсканированных PDF-файлов.
В отсканированном PDF-файле каждая страница обычно сохраняется в виде изображения, а не структурированного текста. Поскольку текст невозможно извлечь напрямую, OCR должен сначала распознать и извлечь текст, прежде чем его можно будет перевести.
Важные примечания
Отсканированные документы распознаются визуально и не содержат исходных текстовых метаданных, которые могут помочь определить язык. Если в качестве исходного языка установлено Автоматическое обнаружение, распознавание и извлечение текста могут быть менее точными.
Рекомендуется для отсканированных документов выберите исходный язык вручную. Выбор правильного языка улучшает как извлечение текста, так и точность распознавания.
Когда Doco Translate обнаруживает отсканированный документ, он также предлагает выбрать исходный язык вручную, чтобы улучшить результаты распознавания и перевода.