Traduire les PDF numérisés
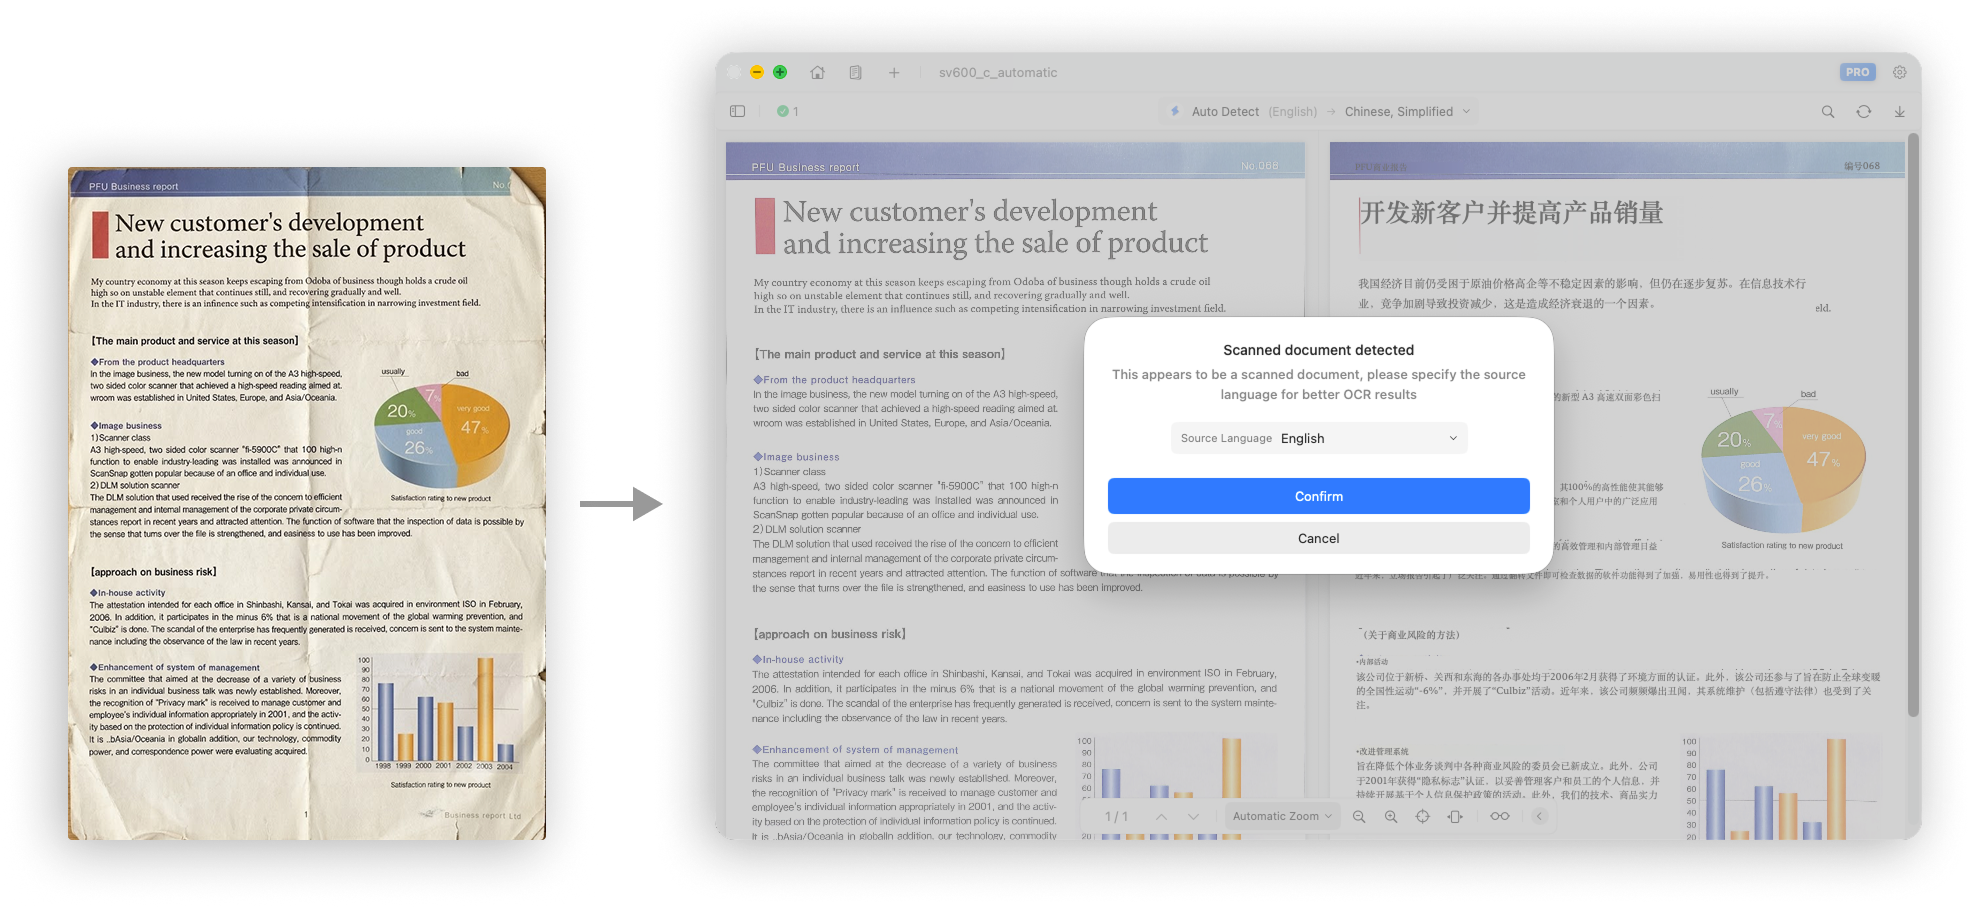
Doco Translate inclut l'OCR pour l'analyse et la traduction des PDF numérisés.
Dans un PDF numérisé, chaque page est généralement stockée sous forme d'image plutôt que de texte structuré. Le texte ne pouvant pas être extrait directement, l’OCR doit d’abord reconnaître et extraire le texte avant de pouvoir le traduire. Traduction
Notes importantes
Les documents numérisés sont reconnus visuellement et ne contiennent pas de métadonnées de texte original pouvant aider à identifier la langue. Si la langue source est définie sur Détection automatique, la reconnaissance et l'extraction de texte peuvent être moins précises.
La meilleure pratique pour les documents numérisés consiste à choisissez la langue source manuellement. La sélection de la bonne langue améliore à la fois l’extraction de texte et la précision de l’OCR.
Lorsque Doco Translate détecte un document numérisé, il vous invite également à choisir manuellement la langue source pour améliorer les résultats de l'OCR et de la traduction.