AIサービス(ローカル)
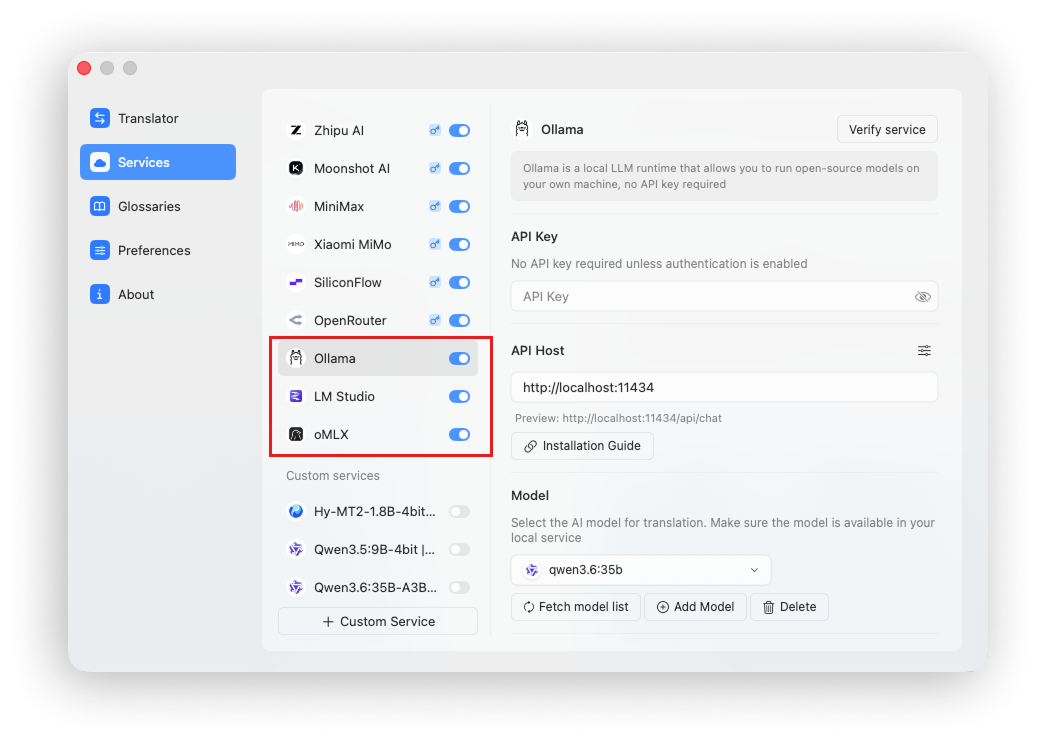
Doco Translate は、Ollama、LM Studio、oMLX などのローカル AI モデル ランタイムに接続して翻訳できます。
ローカルモデルの利点
Uローカル モデルの使用は、いくつかの重要な利点があるため、Doco Translate が最も強く推奨するアプローチです。
翻訳品質
大規模言語モデルは、自然言語タスク、特に翻訳に優れています。これらは通常、従来の機械翻訳エンジンよりも優れた翻訳品質を提供します。
プライバシー
ローカル ランタイムを通じてロードされたモデルは、データをデバイス上に保持します。サードパーティのプロバイダーには何も送信されないため、文書処理のプライバシーが確保されます。
コスト
クラウド AI API とは異なり、ローカル モデルはトークンの料金を請求せず、追加の使用料もかかりません。
ローカル モデルの制限事項
モデルサイズ
ローカル モデルは通常オープン ソースであり、コンシューマ ハードウェアで適切に動作するモデルのパラメータ数は、4B、9B、35B-A3B、27B など比較的小さいことがよくあります。したがって、それらの一般的な機能は大規模なクラウド モデルよりも弱い可能性があります。
ただし、翻訳には非常に長い推論チェーンや可能な限り強力な推論モデルは必要ありません。小規模なローカル モデルは優れた変換を生成できるため、コスト効率の高い選択肢となります。
推論速度
ローカル推論速度は、ハードウェアとモデルのサイズによって異なります。ハードウェアが優れていてモデルが小さいほど高速になりますが、ローカル推論は一般にクラウド AI API よりも依然として遅くなります。
ローカル AI モデル ランタイム
| ツール | の特徴 |
|---|---|
| Oラマ | シンプルなコマンドラインセットアップとモデル管理 |
| LM スタジオ | ローカル モデルをダウンロードして実行するための使いやすいグラフィカル インターフェイス |
| oMLX | Apple シリコンに最適化された高速ローカル LLM 推論 |
Oラマ
Ollama は、ローカル モデルを実行するための親しみやすいコマンド ライン ツールです。
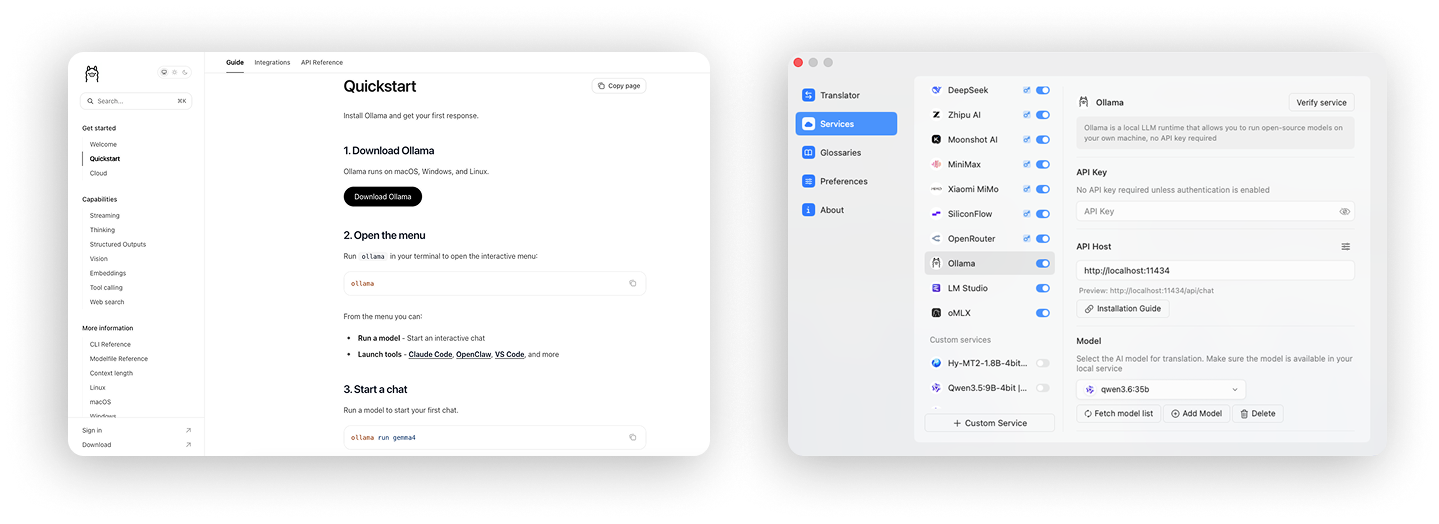
公式の手順に従って Ollama をインストールし、実行します ollama pull MODEL_NAME モデルをダウンロードします。
モデルがダウンロードされ、Ollama で正常に実行されたら、ワンクリックで Doco Translate に接続します。
デフォルトの Ollama エンドポイントは次のとおりです。 http://localhost:11434.
LM スタジオ
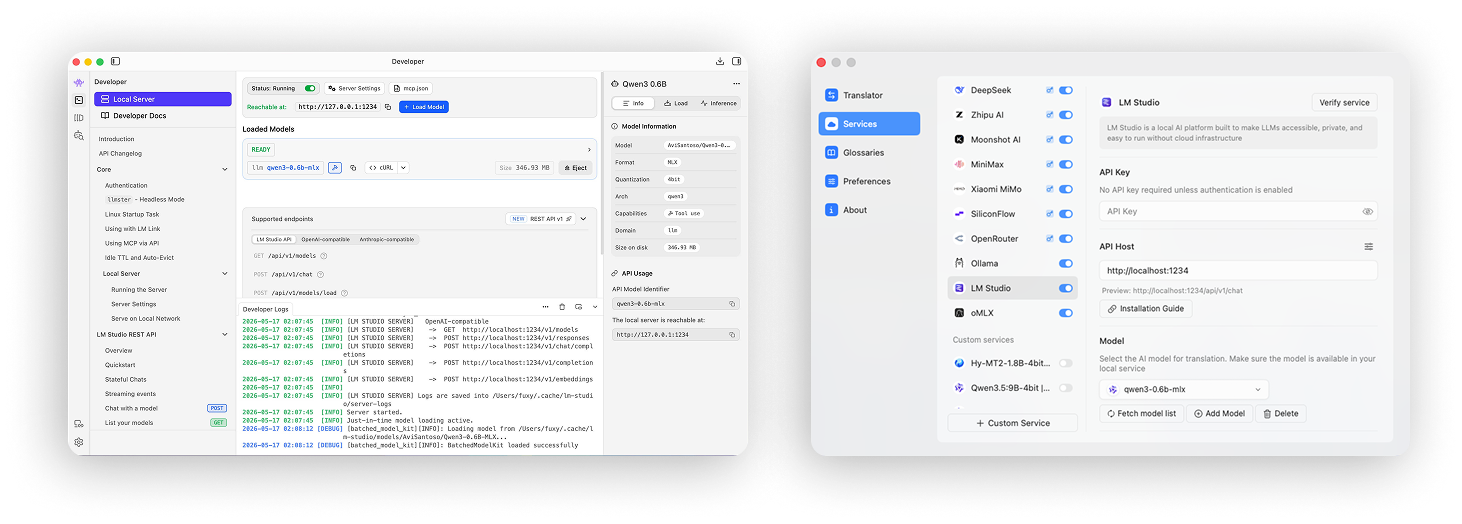
LM Studio は、ローカル モデルを実行するためのグラフィカル インターフェイスを提供しており、簡単に使い始めることができます。
公式 Web サイトから LM Studio をインストールし、アプリ内でモデルをダウンロードします。
モデルのダウンロード後、LM Studio のローカル モデル サーバーを起動して API を公開します。その後、ワンクリックで Doco Translate に接続できます。
デフォルトの LM Studio エンドポイントは次のとおりです。 http://localhost:1234.
oMLX
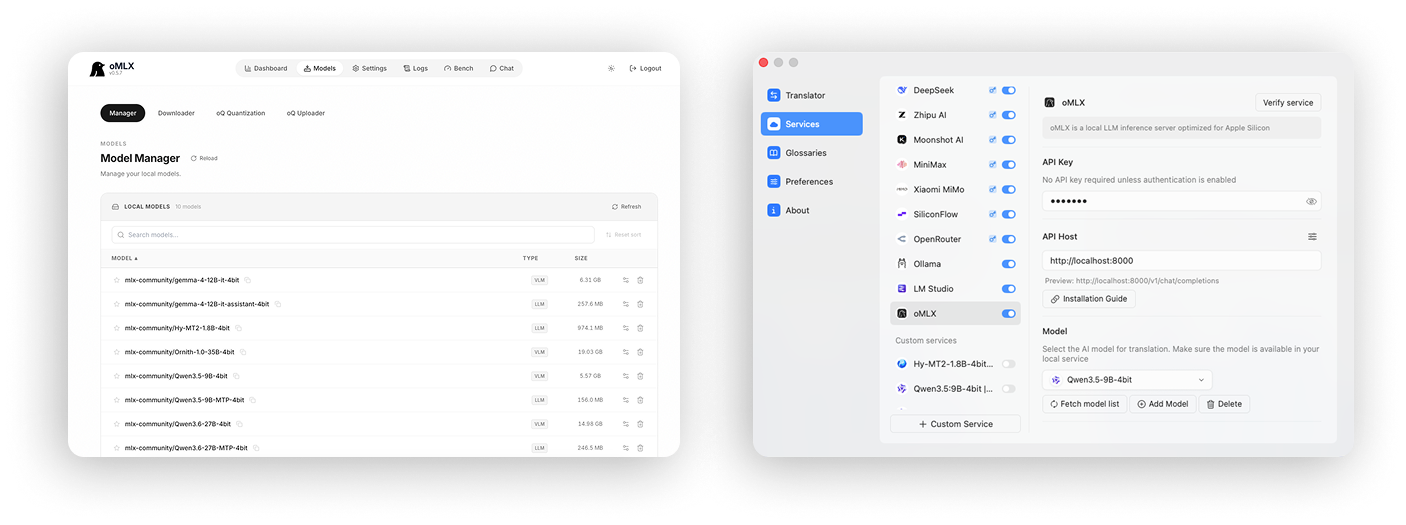
oMLX は、Apple シリコン用に最適化されたローカル モデル ランタイムであり、非常に高速な推論を提供します。
公式 Web サイトから oMLX をインストールし、oMLX コンソールを開いてモデルをダウンロードします。
oMLX はローカル サービスを自動的に開始します。モデルがダウンロードされ、テストに合格したら、ワンクリックで Doco Translate に接続します。
デフォルトの oMLX エンドポイントは次のとおりです。 http://localhost:8000.
おすすめモデル
Doco Translate では、翻訳に次のモデルを推奨しています。
- Hy-MT2-1.8B: 非常に高速でメモリ使用量が最小限に抑えられ、特に翻訳用に最適化されています。
- Qwen3.5:9B: メモリ使用量が比較的少なく高速です
- Qwen3.6:35B-A3B: 強力な機能と高速パフォーマンス、より高いメモリ使用量
- Gemma4:12B: 品質、速度、メモリ使用量のバランスのとれた選択
- Qwen3.6:27B: 最も強力な機能ですが、速度が遅くメモリを大量に消費します
- Qwen3.5:4B: メモリ使用量が少なく高速ですが、安定性がわずかに劣ります
ほとんどのワークロードでは、次を使用します。 Hy-MT2-1.8B または Qwen3.5:9B をプライマリモデルとします。どちらも高速でメモリ効率が高いです。より高い品質と安定性を得るには、次を使用します。 Qwen3.6:35B-A3B。より高機能ですが、より多くのメモリを消費します。