スキャンした PDF を翻訳する
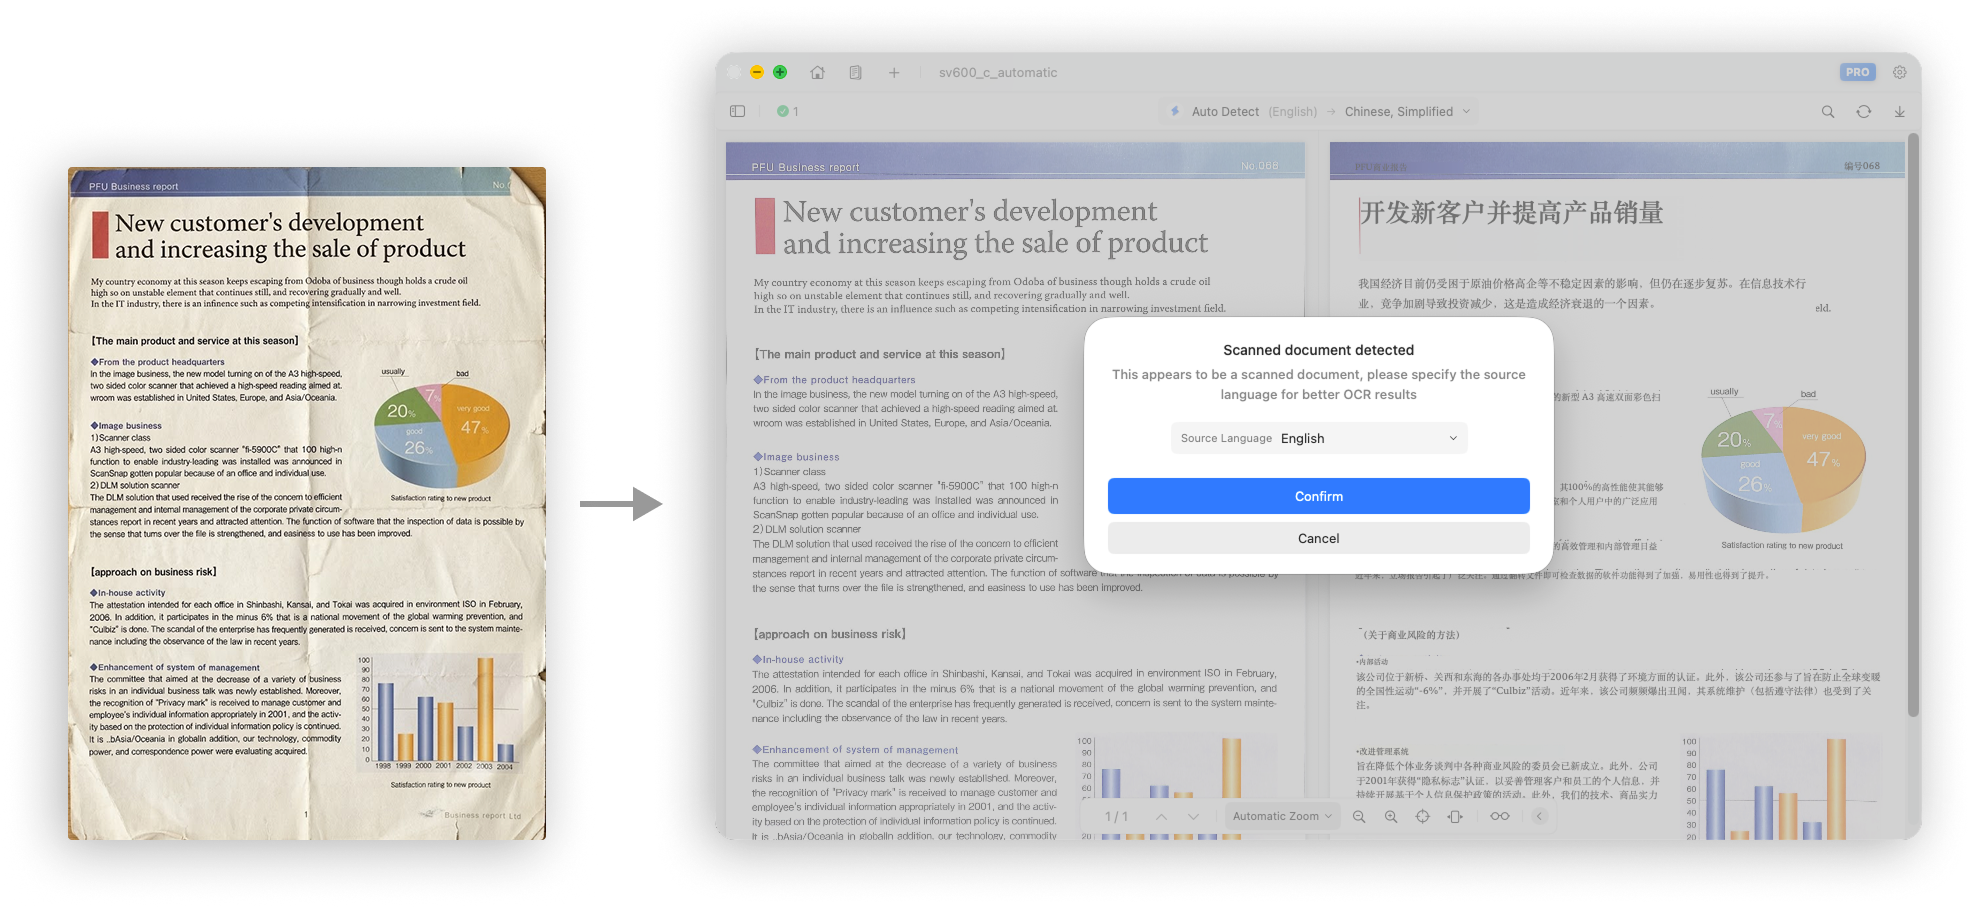
Doco Translate には、スキャンされた PDF を解析および翻訳するための OCR が含まれています。
スキャンされた PDF では、通常、各ページは構造化テキストではなく画像として保存されます。テキストは直接抽出できないため、翻訳する前に、まず OCR でテキストを認識して抽出する必要があります。
重要な注意事項
スキャンされたドキュメントは視覚的に認識され、言語の識別に役立つ元のテキストのメタデータは含まれません。ソース言語がに設定されている場合 自動検出、テキストの認識と抽出の精度が低くなる可能性があります。
スキャンされたドキュメントのベスト プラクティスは次のとおりです。 ソース言語を手動で選択してください。正しい言語を選択すると、テキスト抽出と OCR 精度の両方が向上します。
Doco Translate がスキャンされたドキュメントを検出すると、OCR と翻訳の結果を改善するためにソース言語を手動で選択するよう求められます。