AI Dienste (lokal)
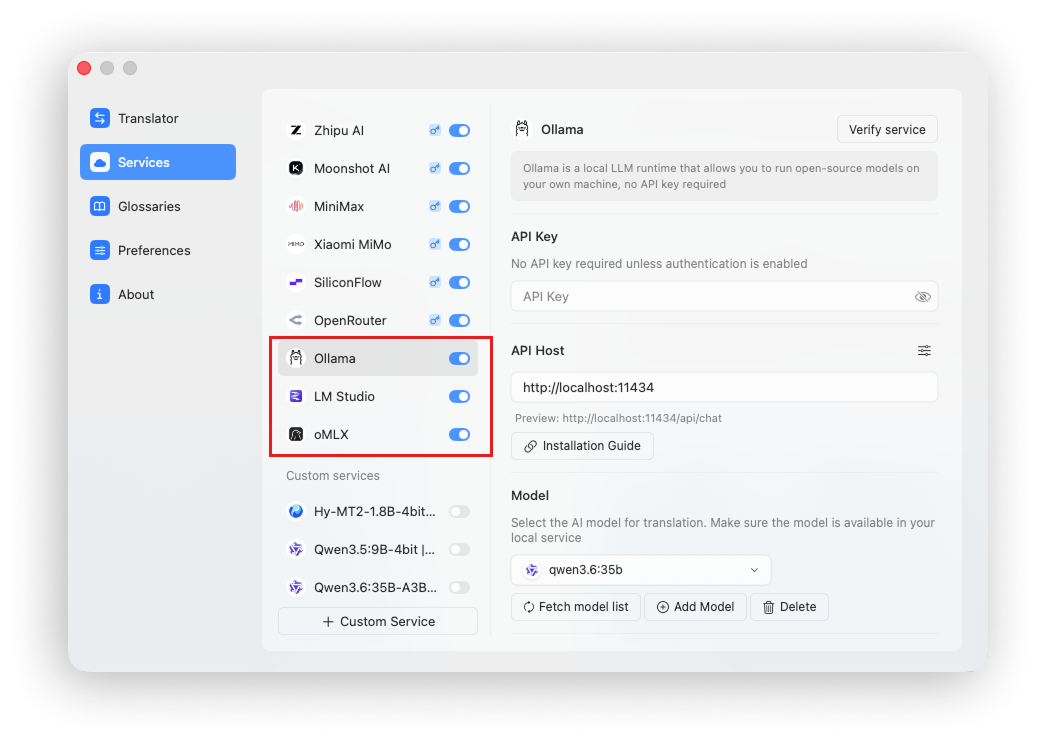
Doco Translate kann zur Übersetzung eine Verbindung zu lokalen KI-Modelllaufzeiten wie Ollama, LM Studio und oMLX herstellen.
Vorteile lokaler Modelle
Die Verwendung lokaler Modelle ist der Ansatz, den Doco Translate am meisten empfiehlt, da er mehrere wichtige Vorteile bietet.
Übersetzungsqualität
Große Sprachmodelle eignen sich hervorragend für Aufgaben in natürlicher Sprache, insbesondere für die Übersetzung. Sie bieten in der Regel eine bessere Übersetzungsqualität als herkömmliche maschinelle Übersetzungsmaschinen.
Datenschutz
Modelle, die über eine lokale Laufzeit geladen werden, behalten Ihre Daten auf Ihrem Gerät. Es wird nichts an einen Drittanbieter gesendet, sodass die Dokumentenverarbeitung vertraulich bleibt.
Kosten
Anders als Cloud-KI-APIs erheben lokale Modelle keine Gebühren für Token und es fallen keine zusätzlichen Nutzungsgebühren an.
Einschränkungen lokaler Modelle
Modellgröße
Lokale Modelle sind normalerweise Open Source, und Modelle, die gut auf Consumer-Hardware laufen, haben oft relativ kleine Parameterzahlen, wie 4B, 9B, 35B-A3B oder 27B. Ihre allgemeinen Fähigkeiten sind daher möglicherweise schwächer als die großer Cloud-Modelle.
Für die Übersetzung ist jedoch keine sehr lange Argumentationskette oder das stärkste mögliche Argumentationsmodell erforderlich. Kleinere lokale Modelle sind in der Lage, gute Übersetzungen zu erstellen, was sie zu einer äußerst kostengünstigen Wahl macht.
Inferenzgeschwindigkeit
Die lokale Inferenzgeschwindigkeit hängt von Ihrer Hardware und der Größe des Modells ab. Bessere Hardware und kleinere Modelle sind schneller, obwohl die lokale Inferenz im Allgemeinen immer noch langsamer ist als eine Cloud-KI-API.
Lokale KI-Modelllaufzeiten
| Tool | Eigenschaften |
|---|---|
| Ollama | Einfache Einrichtung und Modellverwaltung über die Befehlszeile |
| LM Studio | Freundliche grafische Oberfläche zum Herunterladen und Ausführen lokaler Modelle |
| oMLX | Lokale Hochgeschwindigkeits-LLM-Inferenz, optimiert für Apple-Silizium |
Ollama
Ollama ist ein zugängliches Befehlszeilentool zum Ausführen lokaler Modelle.
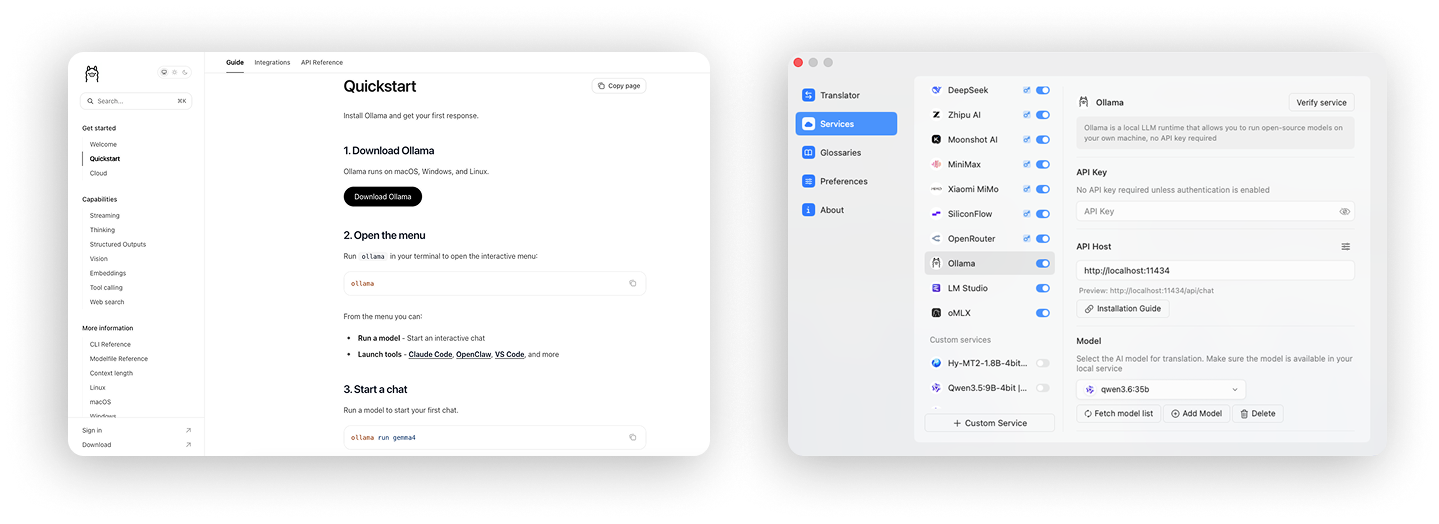
Installieren Sie Ollama, indem Sie den offiziellen Anweisungen folgen, und führen Sie es dann aus ollama pull MODEL_NAME um ein Modell herunterzuladen.
Nachdem das Modell heruntergeladen wurde und erfolgreich in Ollama ausgeführt wird, verbinden Sie es mit einem Klick mit Doco Translate.
Der Standard-Ollama-Endpunkt ist http://localhost:11434.
LM Studio
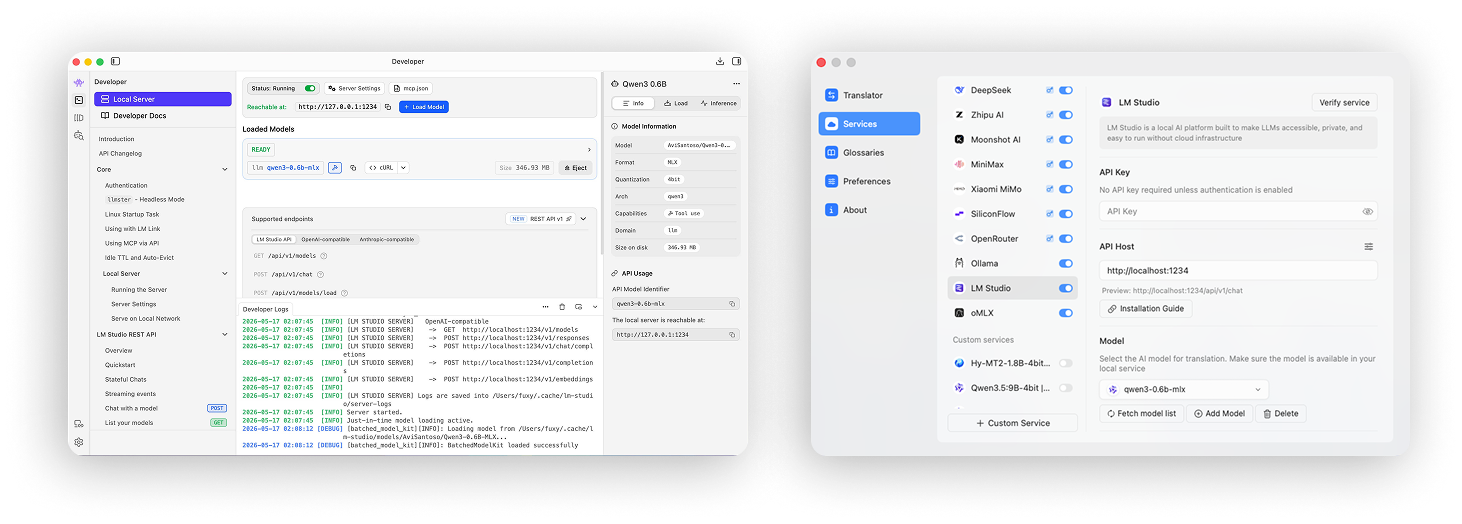
LM Studio bietet eine grafische Oberfläche zum Ausführen lokaler Modelle und ist einfach zu nutzen.
Installieren Sie LM Studio von der offiziellen Website und laden Sie dann ein Modell in der App herunter.
Nachdem das Modell heruntergeladen wurde, starten Sie den lokalen Modellserver von LM Studio, damit er eine API verfügbar macht. Anschließend können Sie es mit einem Klick mit Doco Translate verbinden.
Der Standard-LM Studio-Endpunkt ist http://localhost:1234.
oMLX
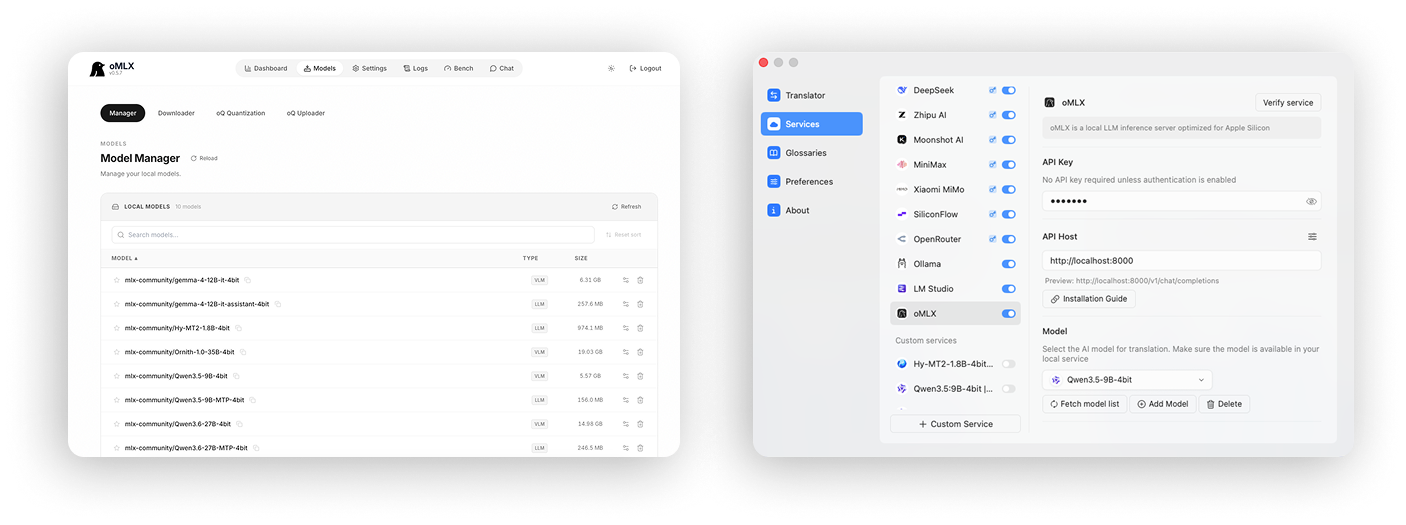
oMLX ist eine lokale Modelllaufzeit, die für Apple-Silizium optimiert ist und eine sehr schnelle Inferenz bietet.
Installieren Sie oMLX von der offiziellen Website, öffnen Sie die oMLX-Konsole und laden Sie ein Modell herunter.
oMLX startet seinen lokalen Dienst automatisch. Nachdem das Modell heruntergeladen und einen Test bestanden hat, verbinden Sie es mit einem Klick mit Doco Translate.
Der Standard-oMLX-Endpunkt ist http://localhost:8000.
Empfohlene Modelle
Doco Translate empfiehlt die folgenden Modelle für die Übersetzung:
- Hy-MT2-1.8B: sehr schnell, minimaler Speicherverbrauch und speziell für die Übersetzung optimiert
- Qwen3.5:9B: schnell mit relativ geringem Speicherverbrauch
- Qwen3.6:35B-A3B: starke Fähigkeiten und schnelle Leistung bei höherer Speichernutzung
- Gemma4:12B: eine ausgewogene Wahl für Qualität, Geschwindigkeit und Speichernutzung
- Qwen3.6:27B: die stärksten Funktionen, aber langsamer und speicherintensiv
- Qwen3.5:4B: schnell mit geringem Speicherverbrauch, aber etwas weniger stabil
Für die meisten Workloads verwenden Sie Hy-MT2-1.8B oder Qwen3.5:9B als primäres Modell. Beide sind schnell und speichereffizient. Für höhere Qualität und Stabilität verwenden Sie Qwen3.6:35B-A3B, das leistungsfähiger ist, aber mehr Speicher verbraucht.