AI (locales)
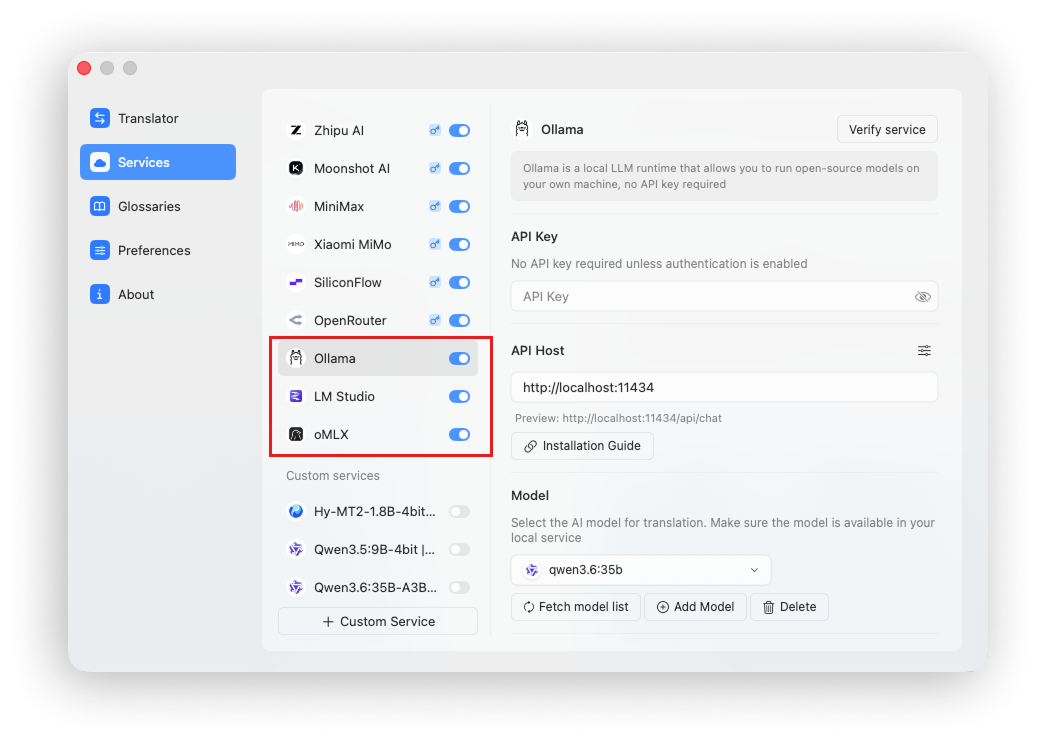
Doco Translate puede conectarse a tiempos de ejecución de modelos de IA locales como Ollama, LM Studio y oMLX para traducción.
Aventajas de los modelos locales
UUsar modelos locales es el enfoque que Doco Translate recomienda más porque ofrece varias ventajas importantes.
Calidad de traducción
Los modelos de lenguajes grandes destacan en tareas de lenguaje natural, especialmente en traducción. Suelen ofrecer una mejor calidad de traducción que los motores de traducción automática convencionales.
Privacidad
Los modelos cargados a través de un tiempo de ejecución local mantienen sus datos en su dispositivo. No se envía nada a un proveedor externo, lo que garantiza que el procesamiento de documentos siga siendo privado.
Costo
UA diferencia de las API de IA en la nube, los modelos locales no cobran por los tokens y no tienen tarifas de uso adicionales.
Limitaciones de los modelos locales
Tamaño del modelo
Los modelos locales suelen ser de código abierto y los modelos que funcionan bien en hardware de consumo suelen tener un número de parámetros relativamente pequeño, como 4B, 9B, 35B-A3B o 27B. Por lo tanto, sus capacidades generales pueden ser más débiles que las de los grandes modelos de nube.
Sin embargo, la traducción no requiere una cadena de razonamiento muy larga ni el modelo de razonamiento más sólido posible. Los modelos locales más pequeños son capaces de producir buenas traducciones, lo que los convierte en una opción muy rentable.
Velocidad de inferencia
La velocidad de inferencia local depende de su hardware y del tamaño del modelo. Un mejor hardware y modelos más pequeños son más rápidos, aunque la inferencia local generalmente sigue siendo más lenta que una API de IA en la nube.
Tiempos de ejecución del modelo de IA local
| Herramienta | Características |
|---|---|
| Ollama | Configuración sencilla de línea de comandos y gestión de modelos |
| LM Estudio | Interfaz gráfica amigable para descargar y ejecutar modelos locales |
| oMLX | Inferencia LLM local de alta velocidad optimizada para Apple Silicon |
Ollama
Ollama es una herramienta de línea de comandos accesible para ejecutar modelos locales.
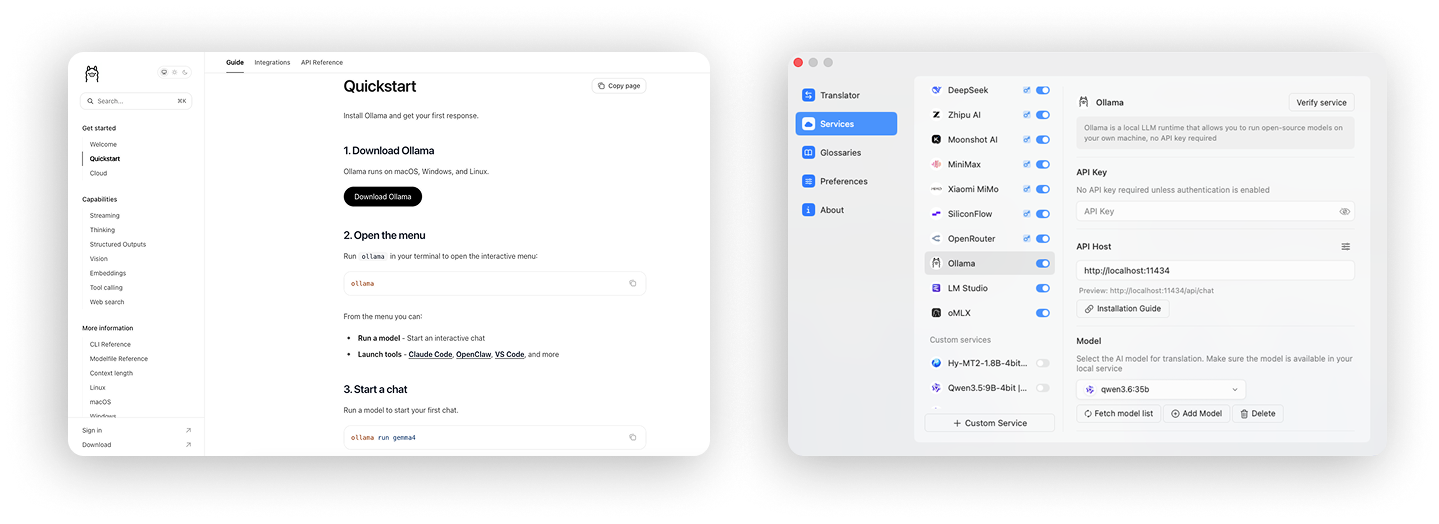
Instale Ollama siguiendo sus instrucciones oficiales, luego ejecute ollama pull MODEL_NAME para descargar un modelo.
Después de que el modelo se haya descargado y se esté ejecutando exitosamente en Ollama, conéctelo a Doco Translate con un clic.
El punto final predeterminado de Ollama es http://localhost:11434.
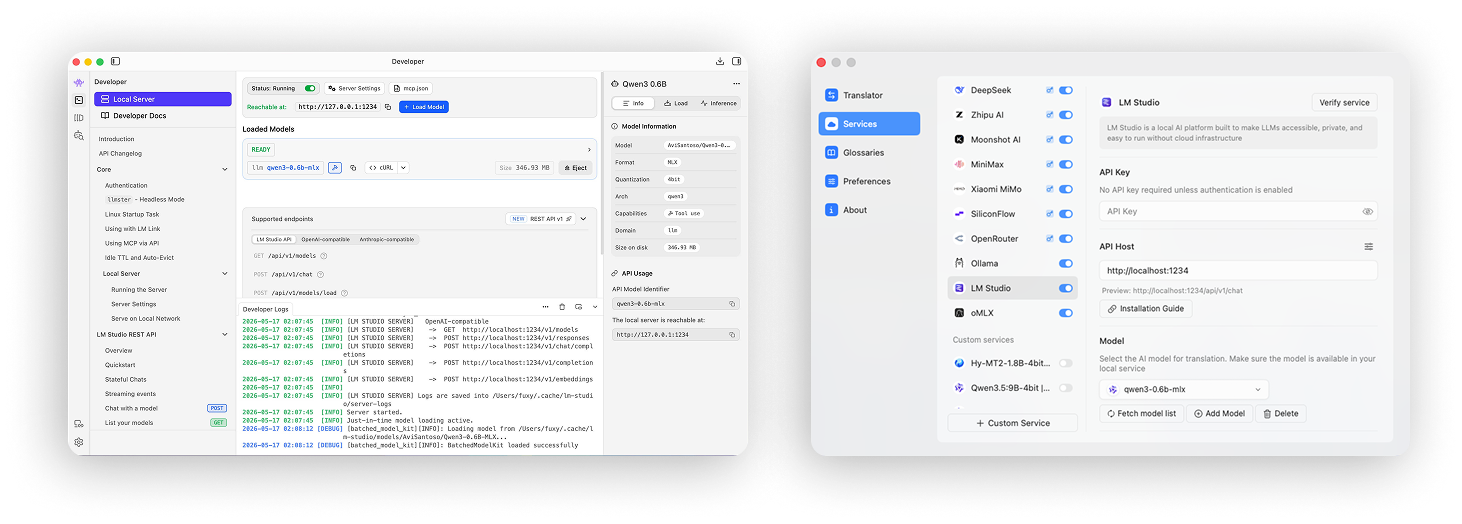
LM Estudio
LM Studio proporciona una interfaz gráfica para ejecutar modelos locales y es fácil comenzar con ella.
Instale LM Studio desde su sitio web oficial, luego descargue un modelo dentro de la aplicación.
Después de descargar el modelo, inicie el servidor de modelo local de LM Studio para que exponga una API. Luego puede conectarlo a Doco Translate con un solo clic.
El punto final predeterminado de LM Studio es http://localhost:1234.
oMLX
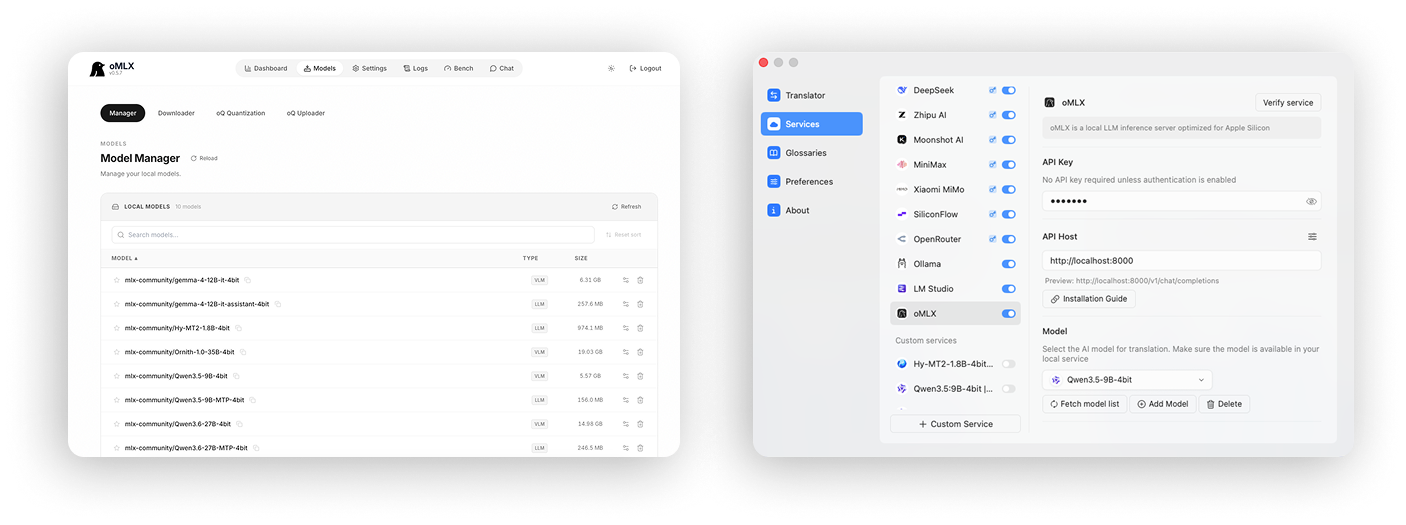
oMLX es un tiempo de ejecución de modelo local optimizado para Apple Silicon y proporciona una inferencia muy rápida.
Instale oMLX desde su sitio web oficial, abra la consola oMLX y descargue un modelo.
oMLX inicia su servicio local automáticamente. Una vez que el modelo se haya descargado y pasado una prueba, conéctelo a Doco Translate con un solo clic.
El endpoint predeterminado de oMLX es http://localhost:8000.
Modelos recomendados
Doco Translate recomienda los siguientes modelos para traducción:
- Hy-MT2-1.8B: muy rápido, uso mínimo de memoria y optimizado específicamente para traducción
- Qwen3.5:9B: rápido con un uso de memoria relativamente bajo
- Qwen3.6:35B-A3B: capacidades sólidas y rendimiento rápido, con mayor uso de memoria
- Gemma4:12B: una opción equilibrada en calidad, velocidad y uso de memoria
- Qwen3.6:27B: las capacidades más potentes, pero más lentas y con mucha memoria
- Qwen3.5:4B: rápido con poco uso de memoria, pero ligeramente menos estable
Para la mayoría de las cargas de trabajo, utilice Hy-MT2-1.8B o Qwen3.5:9B como modelo principal. Ambos son rápidos y eficientes en memoria. Para mayor calidad y estabilidad, utilice Qwen3.6:35B-A3B, que es más capaz pero consume más memoria.