Traducir archivos PDF escaneados
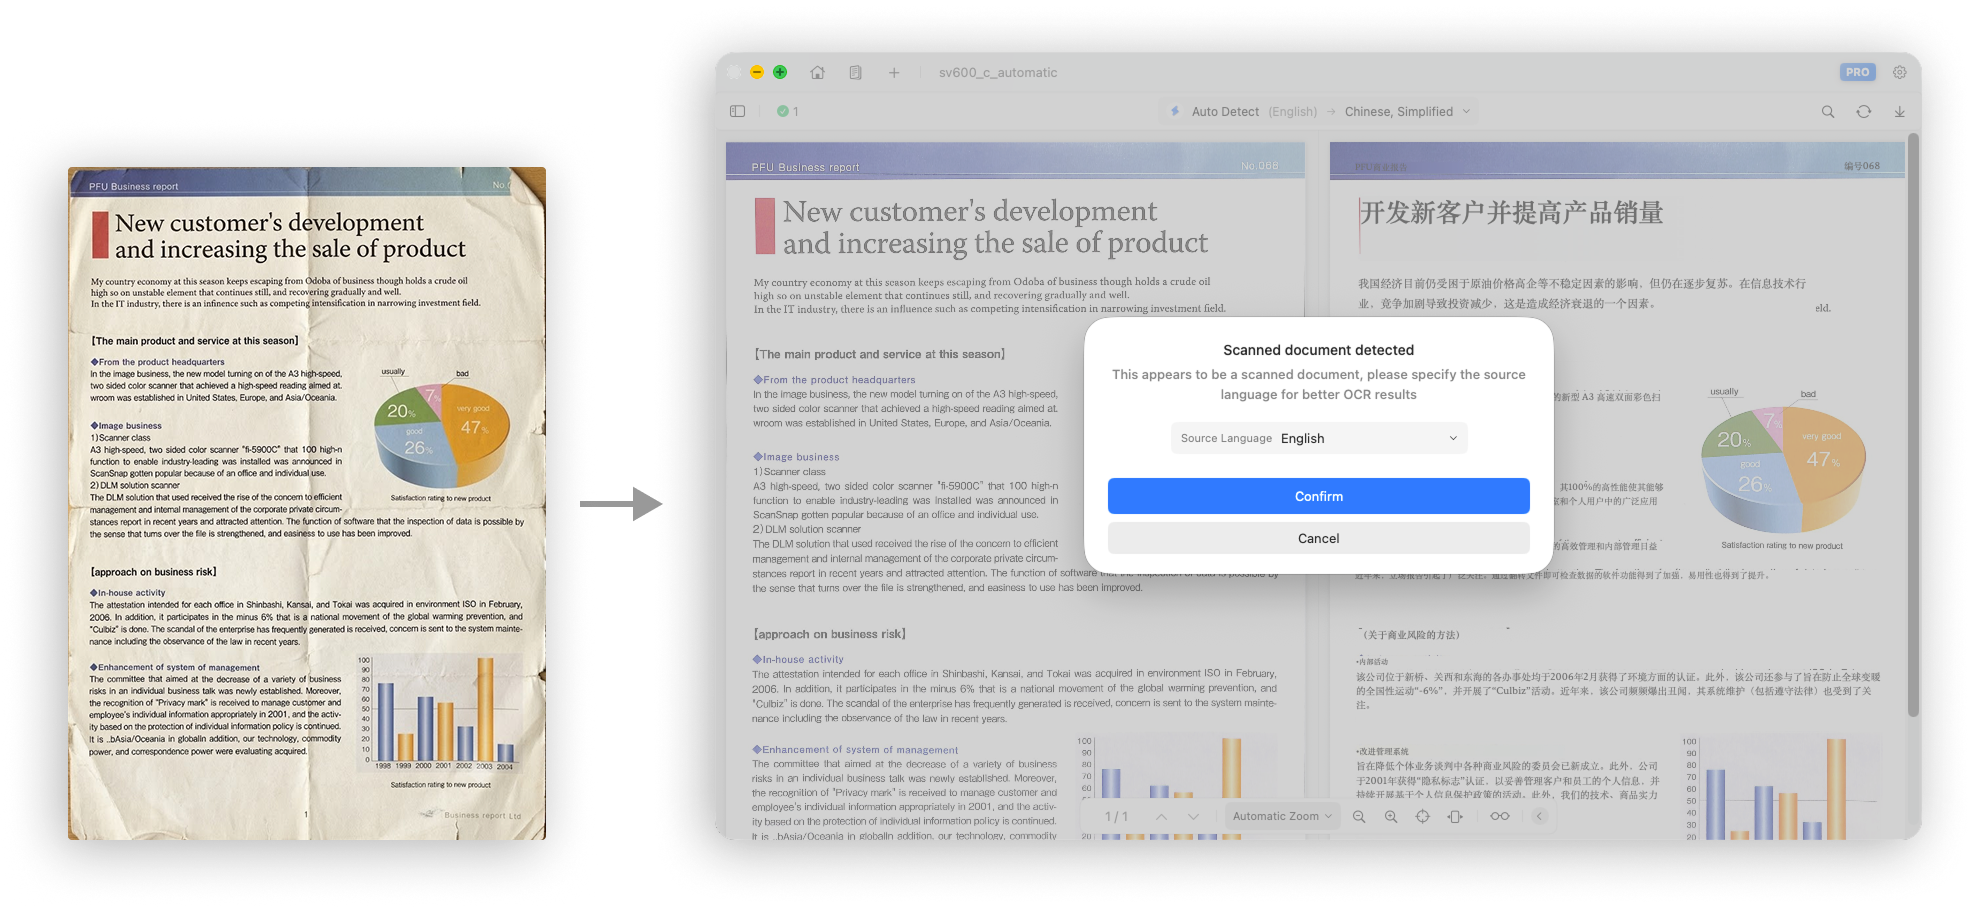
Doco Translate incluye OCR para analizar y traducir archivos PDF escaneados.
En un PDF escaneado, cada página generalmente se almacena como una imagen en lugar de texto estructurado. Como el texto no se puede extraer directamente, el OCR primero debe reconocerlo y extraerlo antes de poder traducirlo. Traducción
Notas importantes
Los documentos escaneados se reconocen visualmente y no contienen metadatos de texto originales que puedan ayudar a identificar el idioma. Si el idioma de origen está configurado en Detección automática, el reconocimiento y la extracción de texto pueden ser menos precisos.
La mejor práctica para documentos escaneados es elija el idioma de origen manualmente. Seleccionar el idioma correcto mejora tanto la extracción de texto como la precisión del OCR.
Cuando Doco Translate detecta un documento escaneado, también le solicita que elija el idioma de origen manualmente para mejorar el OCR y los resultados de traducción.